Executive Summary
- LLM 추론의 병목은 GPU 연산량보다 메모리일 수 있습니다. 긴 컨텍스트와 동시 요청이 늘면 KV Cache가 HBM(High Bandwidth Memory)을 빠르게 점유해 Cache 재계산과 응답 지연을 일으킵니다.
- 이 문제는 GPU를 추가하는 것만으로 해결되지 않습니다. KV Cache Offload로 저장 공간을 넓히고, Sleep/Wake로 유휴 자원을 재사용하며, NPU로 추론 하드웨어를 워크로드에 맞게 분산해야 합니다.
- 핵심은 특정 기술의 도입 자체가 아니라 병목에 맞는 메모리·시간·하드웨어 설계입니다. Cache 적중률, 전송 비용, Wake 지연, 모델 호환성을 함께 따져야 같은 인프라에서 더 많은 요청을 안정적으로 처리할 수 있습니다.
지난 아티클 「토큰 팩토리의 생산성을 끌어올리는 인퍼런스 기술」이 공장 내부의 생산성을, 「AI 추론 서비스의 관문, Inference Gateway」가 공장 문 앞의 판단을 다뤘다면, 이번 아티클은 공장 안의 자리 문제를 다룹니다.
설비도 충분하고 주문 배정도 잘 되는데, 작업대에 반제품이 쌓여 더 이상 새 주문을 올릴 자리가 없는 상황을 생각해 봅니다. 기계는 절반쯤 놀고 있지만 라인은 멈춥니다. 설비를 한 대 더 들이면 해결될까요? 아니면 자재를 어디에 어떻게 놓을지부터 다시 정해야 할까요? LLM 추론 서비스에서 GPU 메모리를 두고 벌어지는 일이 정확히 이것입니다. 연산 유닛에는 여유가 있는데 메모리가 먼저 차버려서 처리량이 묶입니다. 그런데 "메모리가 부족하다"는 같은 증상이라도 원인은 제각각이고, 손을 대야 할 지점도 다릅니다. 실무에서 마주치는 형태는 대체로 셋입니다.
첫째, 요청 하나하나가 길어서 자리가 모자란 경우. 긴 컨텍스트와 다중 동시 요청으로 KV Cache가 메모리를 잠식하는 상황입니다. 모델은 하나뿐인데 배치 크기를 올리면 바로 OOM(Out of Memory)이 발생합니다. 작업대에 쌓인 반제품을 옆 창고에 잠시 내려놓는 것에 해당하는 접근이 KV Cache Offload입니다.
둘째, 모델을 여러 개 올려두고 번갈아 쓰는 경우. 각 모델의 호출 빈도는 낮은데 가중치가 메모리를 계속 점유합니다. 지금 돌리지 않는 라인을 잠시 접어두고, 필요할 때 다시 펴는 방식이 Sleep/Wake입니다.
셋째, 워크로드 자체가 GPU 한 장의 메모리 예산을 구조적으로 넘어서는 경우. 위 두 가지로 짜내도 답이 안 나오거나, 나와도 비용 효율이 맞지 않습니다. 이때는 공정을 다른 설비로 옮기는 선택, 즉 NPU 활용이 논의 대상이 됩니다.
세 가지는 배타적이지 않고 함께 쓰이기도 합니다. 중요한 건 순서입니다. 먼저 병목이 어디에서 생기는지 구분하고, 그다음에 어떤 카드를 쓸지 정합니다. 이어지는 장에서 각각을 차례로 다룹니다.
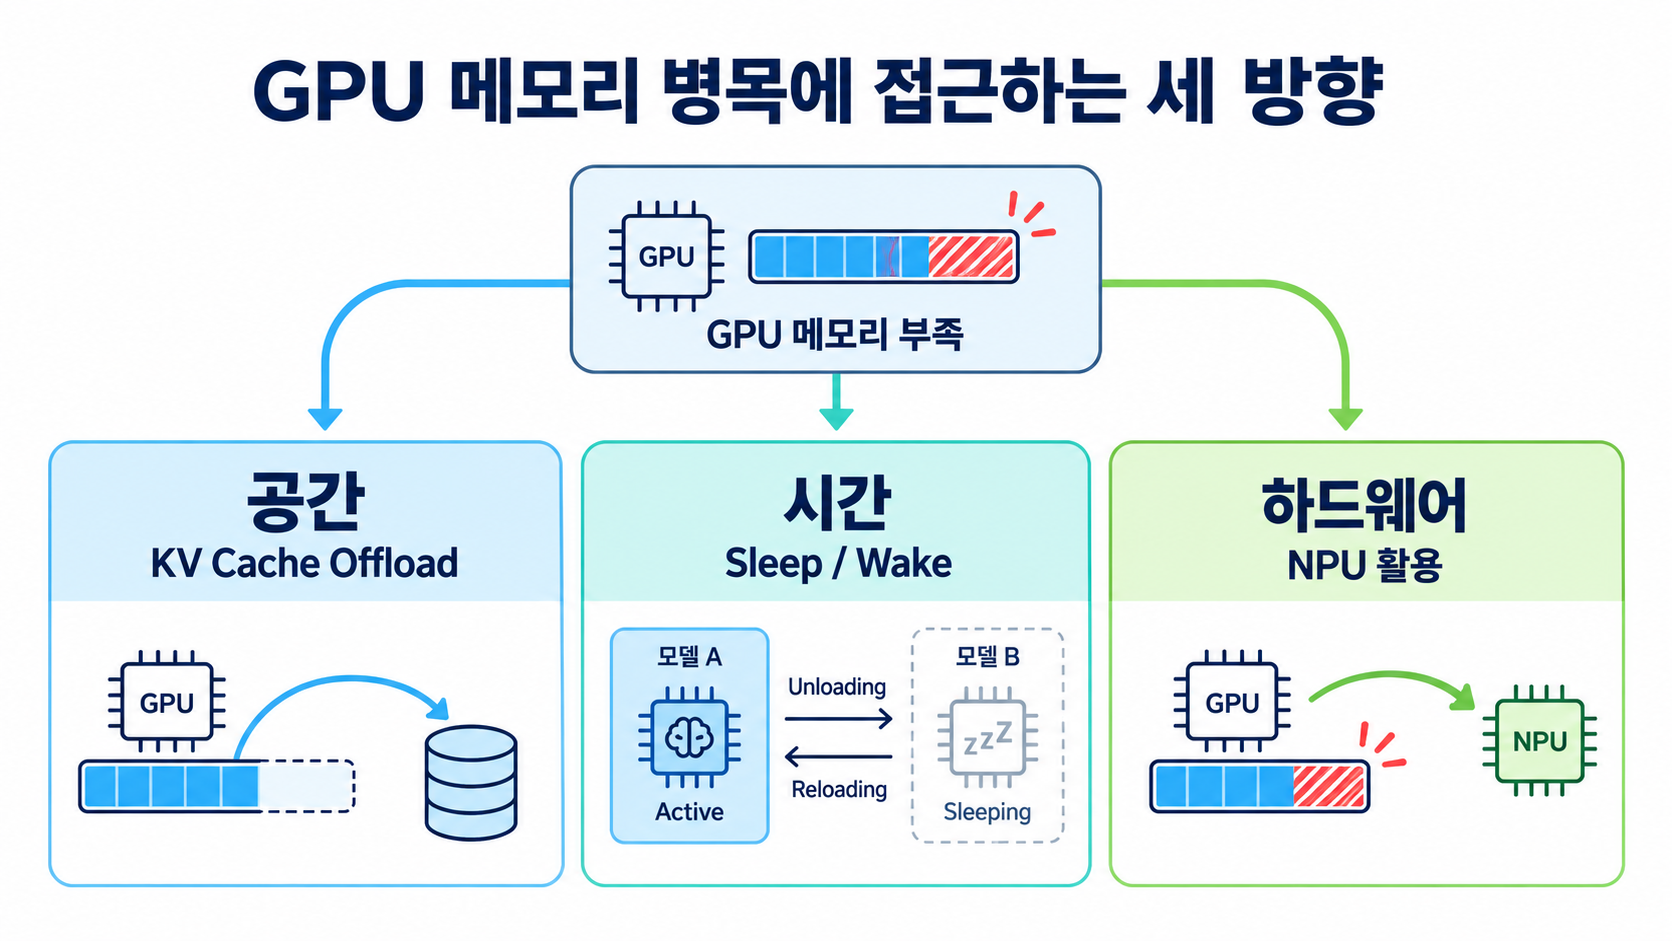 [그림1] GPU 메모리 병목에 접근하는 세 방향 — 공간(Offload), 시간(Sleep/Wake), 하드웨어(NPU) (출처: 삼성SDS)
GPU 메모리 병목에 접근하는 세 방향
- GPU 메모리 부족
- 공간 - KV Cache Offload
- 시간 - Sleep / Wake
- 하드웨어 - NPU 활용
1. 계산을 저장으로 바꾸다 — KV Cache Offload
트랜스포머가 토큰을 하나 만들 때, 모델은 앞에 나온 모든 토큰을 다시 들여다봅니다. 100번째 토큰을 생성하려면 1번부터 99번까지의 Key와 Value가 필요하고, 101번째 토큰에서도 같은 것이 또 필요합니다. 매번 처음부터 다시 계산한다면 같은 연산을 수천 번 반복하는 셈입니다.
그래서 한 번 계산한 Key와 Value를 메모리에 남겨두고 재사용합니다. 이것이 KV Cache이고, 오늘날 LLM 추론이 실용적인 속도를 내는 이유입니다. 재계산의 반복을 메모리 점유로 맞바꾼 것입니다.
문제는 이러한 메모리 점유가 컨텍스트 길이에 비례해서 늘어난다는 점입니다. 일반적으로 8B급 모델 이면 토큰 하나당 약 128KB입니다. 8K 컨텍스트 요청 하나가 1GB, 128K 장문 요청 하나가 16GB를 차지합니다. 가중치 16GB를 올린 80GB GPU에서, 장문 요청 네 개면 자리가 없습니다.
여기서 생기는 증상이 앞서 말한 메모리가 부족한 상황입니다. GPU 사용률은 50%인데 새 요청은 큐에서 대기합니다. 연산이 부족한 게 아니라 KV Cache를 놓을 자리가 부족한 것이고, 그래서 GPU를 한 장 더 붙이는 건 정확한 해결 방법이 아닙니다. 필요한 건 "지금 당장 쓰지 않는 반제품을 어디에 내려놓을까"에 대한 답입니다.
LLM 서비스의 새로운 병목: 계산과 메모리의 반복
LLM 추론 과정은 입력을 읽고 이해하는 Prefill과 답변을 한 토큰씩 만드는 Decode로 나뉩니다. Prefill에서는 첫 번째 답변 토큰을 만들기 전에 전체 입력을 모델의 모든 계층에서 처리합니다. GPU가 한 번에 처리할 수 있는 토큰 수는 연산 성능과 메모리 용량에 따라 제한되므로, 긴 입력을 반복해서 Prefill하면 그만큼 GPU를 오래 점유합니다. Prefill과 Decode가 같은 GPU 자원을 나눠 쓰는 환경에서는 새 요청의 첫 응답만 늦어지는 것이 아니라, 이미 답변을 생성 중인 요청의 Decode도 밀려 토큰 생성 속도까지 떨어질 수 있습니다.
이러한 부담은 생성형 AI가 단순한 질의응답에서 에이전트로 발전하면서 더 커지고 있습니다. 에이전트는 목표를 달성할 때까지 도구를 호출하고 결과를 확인하는 과정을 반복하며, 그때마다 프롬프트와 대화 이력, 작업 결과가 다시 입력됩니다. 스탠퍼드대 연구진의 에이전트 코딩 연구에서는 특정 실험 조건에서 일반적인 코드 질의보다 최대 1,000배 많은 토큰이 사용됐고, 그중 상당 부분을 Input Token이 차지했습니다. 모델이 한 번에 처리할 수 있는 Context도 빠르게 커지고 있습니다. DeepSeek는 V3에서 V4로 넘어가며 최대 Context가 128K에서 1M로 약 8배 늘었습니다.
입력과 동시 요청이 늘어날수록 GPU HBM의 여유 공간은 빠르게 줄어듭니다. HBM에는 모델 가중치뿐 아니라 추론 과정에서 생성되는 Activation, CUDA Graph가 예약하는 메모리, Attention·연산 커널의 임시 작업 공간과 KV Cache가 함께 올라갑니다. 이 가운데 KV Cache에 사용할 수 있는 공간이 부족해지면 오래된 캐시가 제거되고, 같은 문맥이 다시 요청됐을 때 Prefill을 처음부터 수행해야 합니다.
이 문제는 실제 서비스의 입력이 반복된다는 점에서 더 커집니다. 시스템 프롬프트, 참고 문서, RAG 자료, 이전 대화와 작업 이력은 여러 요청의 공통 Prefix로 다시 사용됩니다. 유효한 KV Cache를 오래 보존하지 못하면 GPU는 이미 처리한 Prefix를 반복해서 계산하고, 그만큼 새로운 요청의 Prefill과 진행 중인 Decode에 사용할 자원이 줄어듭니다.
KV Cache Offload는 이 지점에서 접근을 바꿉니다. GPU HBM에 모두 보관하기 어려운 KV Cache를 CPU 메모리나 스토리지로 옮겨 수명을 늘리고, 필요할 때 다시 불러와 사용합니다. GPU는 이미 끝낸 입력 계산을 반복하는 대신 새로운 요청의 Prefill과 진행 중인 Decode에 더 많은 자원을 사용할 수 있습니다.
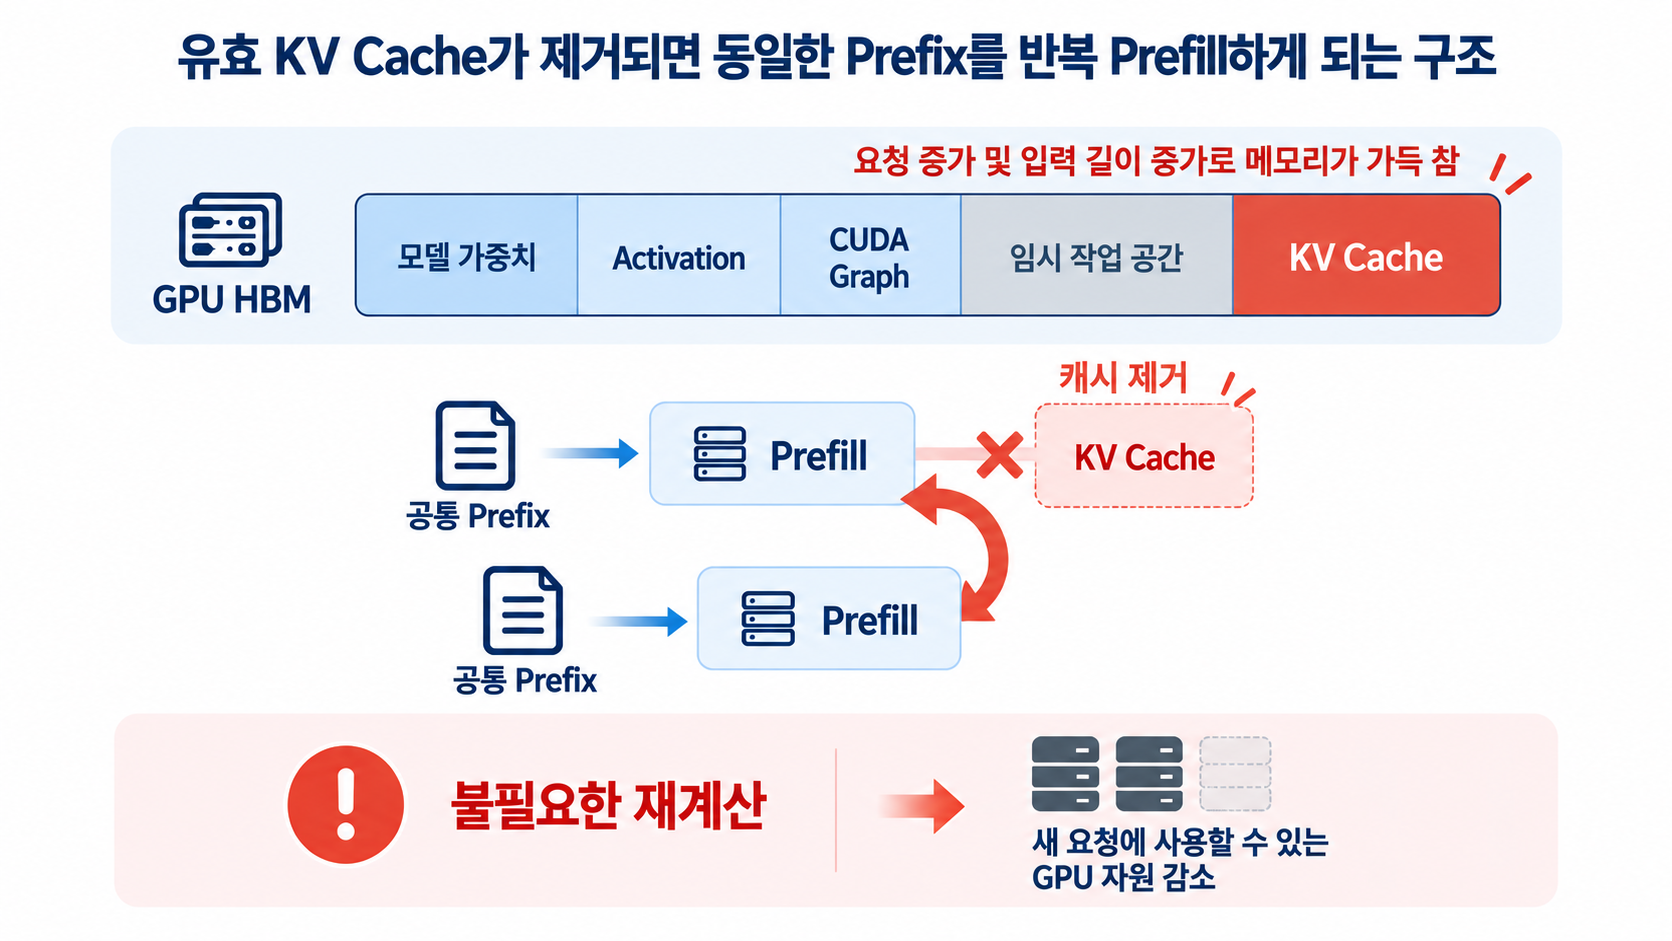 [그림2] 유효 KV Cache가 제거되면 동일한 Prefix를 반복 Prefill하게 되는 구조 (출처: 삼성SDS)
유효 KV Cache가 제거되면 동일한 Prefix를 반복 Prefill하게 되는 구조
- GPU HBM [모델 가중치 / Activation / CUDA Graph / 임시 작업 공간 / KV Cache] - 요청 중가 및 입력 길이 중가로 메모리가 가득 참
- 공통 Prefix → Prefill ←→ 공통 Prefix → Prefill - 캐시 제거[KV Cache]
- 불필요한 재계산 → 새 요청에 사용할 수 있는 GPU 자원 감소
계산을 저장으로 바꾸는 메모리 계층화
일반적인 KV Cache 계층은 GPU HBM에서 시작해 CPU Memory, 로컬 NVMe, 원격 공유 저장소로 범위를 넓힙니다. GPU에 가까운 계층은 빠르지만, 공간이 작고 멀리 있는 계층은 상대적으로 느리지만 더 많은 Cache를 보관할 수 있습니다. 계산이 완료된 동일한 KV Cache 블록은 설정된 여러 저장 계층으로 비동기 복제될 수 있으며, 하나의 Cache가 여러 계층에 동시에 존재할 수 있습니다. 구체적인 Write·Lookup·Read 경로는 서빙 엔진과 Backend 구조에 따라 달라집니다.
예를 들어 vLLM 0.28.0 코드에서 SimpleCPUOffloadConnector는 별도 Backend를 지정하지 않으면 CPU Memory를 기본값으로 사용합니다. 기본 동작은 계산이 완료된 캐시 블록을 HBM의 Eviction 시점까지 기다리지 않고 CPU Memory로 비동기 복사합니다. Local Disk는 disk Backend를 명시적으로 선택했을 때 사용하는 선택 기능이며, 이 경우 CPU Memory는 Disk 입출력을 위한 전송 영역으로 사용됩니다.
여러 저장 계층을 함께 사용하는 Tier 구조에서는 CPU Memory가 필수 Primary Tier이고, Local Disk·원격 저장소 등을 하나 이상의 Secondary Tier로 구성합니다. GPU에서 CPU Memory로 저장이 완료되면 동일한 캐시 블록을 설정된 모든 Secondary Tier에 비동기 저장합니다. 조회는 CPU Primary Tier를 먼저 확인하고, Cache Miss이면 설정 순서대로 Secondary Tier를 조회합니다. Secondary Tier에서 발견한 캐시는 CPU Memory로 승격한 뒤 GPU로 전달합니다. 따라서 CPU Memory와 Local Disk를 동시에 사용하면서 동일한 캐시를 각 계층에 보관하고, 조회 시 가장 가까운 Cache Hit 경로를 활용할 수 있습니다.
LMCache도 같은 원리로 저장 범위를 더 다양한 Backend까지 확장합니다. 계산이 끝난 KV Cache를 블록 또는 모델 계층 단위로 나누고, GPU 연산과 데이터 전송, 각 Backend의 저장 작업을 겹쳐 수행합니다. 완료된 캐시는 CPU Memory, Local Disk, 원격 저장소처럼 활성화된 계층으로 지속해서 비동기 저장되며, 조회 시에는 가까운 계층부터 캐시를 찾아 상위 계층으로 복구합니다. 이 구조는 GPU의 요청 처리를 이어가면서 여러 저장 계층의 용량을 함께 활용할 수 있게 합니다.
| 계층 | 저장(Write) | 조회/복구(Lookup/Read) | 역할 |
|---|---|---|---|
| GPU HBM | 현재 요청의 계산 결과 유지 | 즉시 사용 | 가장 빠른 실행 영역 |
| CPU Memory | 완료된 캐시를 비동기 복사 | 우선 조회 후 GPU로 복구 | 빠른 재사용과 저장 경로의 중심 |
| Local Disk | CPU 전송 영역을 거쳐 비동기 저장 | 캐시 식별자로 파일을 찾아 CPU·GPU로 복구 | 노드 내 보관 용량 확대 |
| 고성능 병렬 스토리지 | 공유 파일시스템에 캐시와 식별 정보를 비동기 저장 | 공유 경로에서 조회하며, 지원 환경에서는 GPU Direct Storage로 GPU와 직접 전송 | 여러 노드가 공유하는 고성능 캐시 계층 |
| 오브젝트 스토리지 | 캐시 조각별 객체를 비동기 저장 | 객체 존재 여부를 확인하고 내려받아 CPU를 거쳐 GPU로 복구 | 대용량·장기 보관 |
오브젝트 스토리지는 입력 Prefix로 만든 캐시 식별자를 객체 Key로 사용합니다. Lookup은 해당 객체가 존재하는지 확인하는 과정이며, Cache Miss이면 기존처럼 Prefill을 수행합니다. Cache Hit이면 객체를 읽어 CPU Memory에 배치한 뒤 GPU로 전달합니다. 새 캐시는 같은 Key 체계로 비동기 업로드되므로 여러 인스턴스가 동일한 저장소를 조회할 수 있습니다.
고성능 병렬 스토리지는 여러 서버가 함께 접근하는 파일시스템에 캐시 조각과 식별 정보를 저장합니다. GPU Direct Storage를 지원하는 구성에서는 대용량 데이터가 CPU를 경유하지 않고 GPU와 고성능 병렬 스토리지 사이를 직접 이동할 수 있어 전송 경로를 줄일 수 있습니다. 지원하지 않는 환경에서는 CPU를 거치는 일반 파일 입출력 경로를 사용합니다.
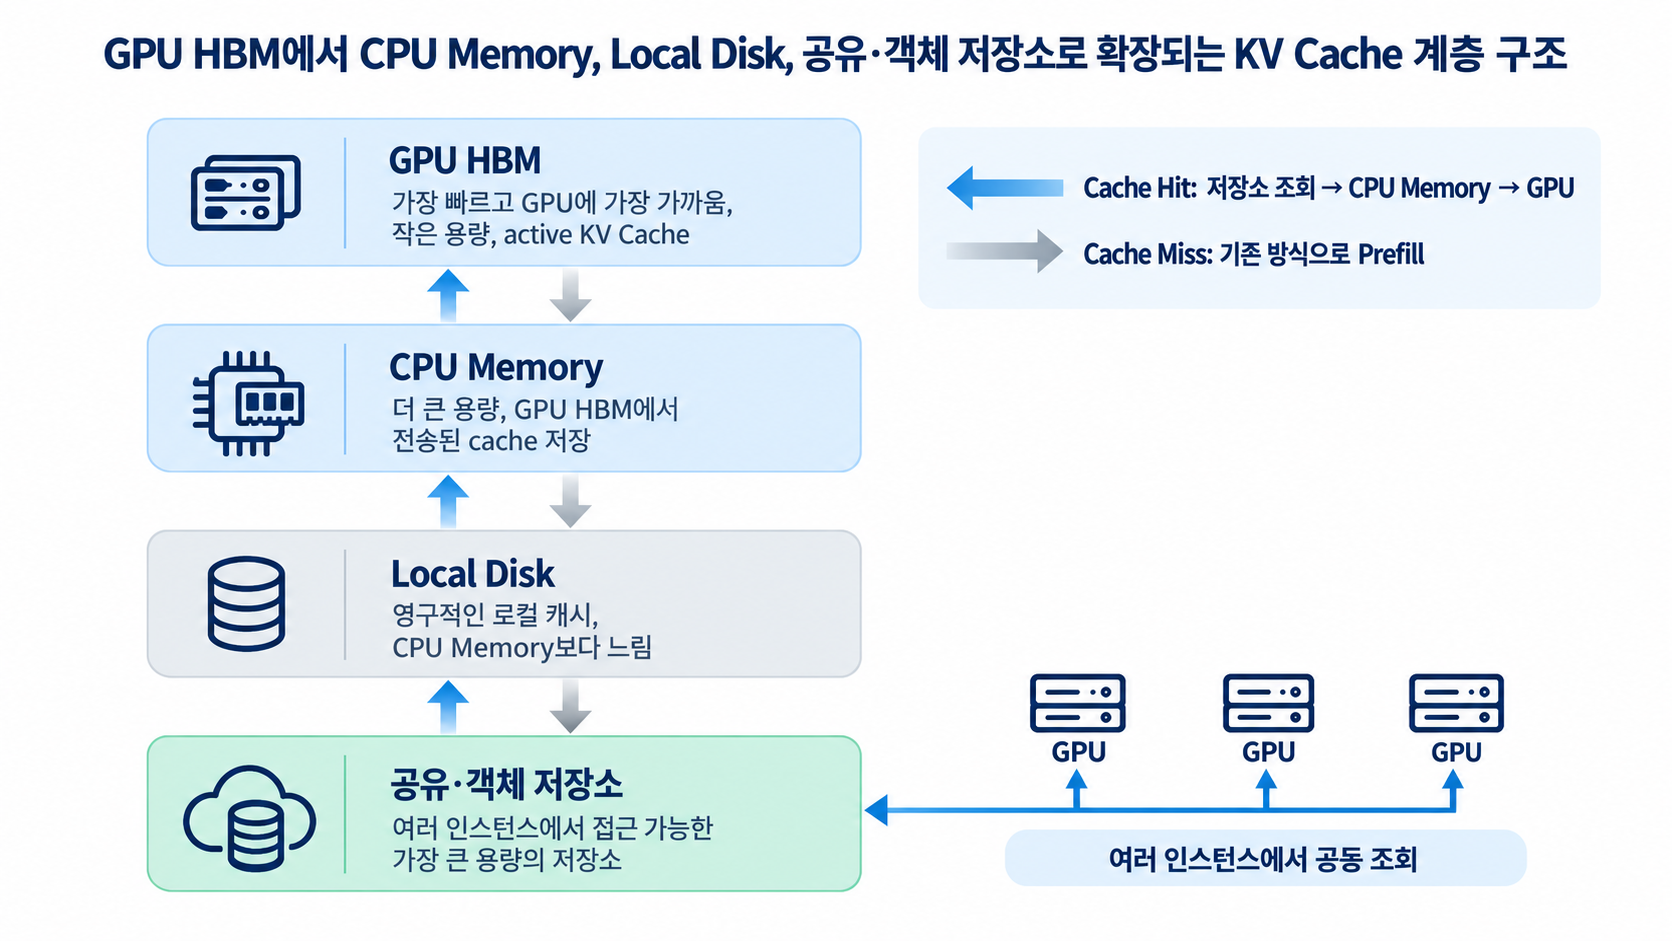 [그림3] GPU HBM에서 CPU Memory, Local Disk, 공유·객체 저장소로 확장되는 KV Cache 계층 구조 (출처: 삼성SDS)
GPU HBM에서 CPU Memory, Local Disk, 공유·객체 저장소로 확장되는 KV Cache 계층 구조
- ★ = Cache Hit: 저장소 조회 → CPU Memory → GPU
- ◆ = Cache Miss: 기존 방식으로 Prefill
- GPU HBM(가장 빠르고 GPU에 가장 가까움,작은 용량, active KV Cache)
- CPU Memory(더 큰 용량, GPU HBM에서 전송된 cache 저장)
- Local Disk(영구적인 로컬 캐시,CPU Memory보다 느림)
- 공유·객체 저장소(여러 인스턴스에서 접근 가능한 가장 큰 용량의 저장소)
GPU HBM ◆ CPU Memory ◆ Local Disk ◆ 공유·객체 저장소 ← 여러 인스턴스에서 공동 조회(GPU,GPU,GPU..) ★ Local Disk ★ CPU Memory ★ GPU HBM
저장이 항상 이득은 아니다 - 전송 비용과 재계산 비용
여기서 중요한 판단은 "저장된 KV 텐서(토큰들의 Key·Value를 레이어별로 쌓아둔 배열)를 옮기는 비용과 긴 입력을 다시 계산하는 비용 중 어느 쪽이 작은가"입니다.
네트워크 전송에는 지연이 들지만, 수만~수십만 토큰의 Prefix를 GPU에서 다시 Prefill하는 과정도 많은 연산 시간과 전력을 소비합니다. 캐시 전송 시간이 재계산 시간보다 짧다면 네트워크를 통한 데이터 이동이 더 빠르고 효율적인 경로가 됩니다. 반대로 Prefix가 짧거나 네트워크가 혼잡하다면 재계산이 나을 수 있습니다.
따라서 반복 가능성이 높은 장문 Prefix는 적극적으로 보관하고, 짧거나 다시 사용될 가능성이 낮은 캐시는 빠르게 정리해야 합니다. 대용량 저장 공간 자체보다, 캐시의 가치와 전송 비용, 재계산 비용을 요청마다 비교하는 정책이 중요합니다.
계층이 여러 노드로 확장되면 지난 아티클 「AI 추론 서비스의 관문, Inference Gateway」에서 소개한 Intelligent Routing과의 결합도 중요해집니다. 특정 인스턴스에 유효한 캐시가 있는데 요청이 다른 곳으로 전달되면 같은 계산을 반복해야 하기 때문입니다. 요청을 캐시가 있는 인스턴스로 보내거나 여러 인스턴스가 공통 캐시 저장소를 공유하면, 데이터 이동을 줄이면서도 장애·교체·스케일링 이후까지 캐시를 이어서 활용할 수 있습니다. 저장 계층을 넓히는 일과 요청을 캐시가 있는 곳으로 보내는 일은 함께 작동할 때 의미가 있습니다.
삼성SDS 추론 서비스에 KV Cache Offload 적용과 효과
(1) 장문 입력 중심의 추론 워크로드
삼성SDS 추론 서비스 출시 이후 모니터링한 결과, Qwen3.6-27B 모델의 요청당 평균 Input은 약 65K Token, Output은 약 0.5K Token으로 확인됐습니다. Input이 Output보다 약 130배 길어 전체 처리 시간과 GPU 사용량에서 장문 Input의 Prefill이 차지하는 비중이 큽니다.
평균 65K 수준의 장문 요청은 요청 하나만으로도 수 GB의 KV Cache를 생성할 수 있습니다. 이러한 요청이 동시에 처리되면 HBM에 보관할 수 있는 캐시의 수와 유지 시간이 빠르게 줄어듭니다. 실제 용량은 모델의 Attention 구조, 캐시 정밀도와 서빙 엔진의 메모리 배치 방식에 따라 달라지므로 운영 지표를 기준으로 관리해야 합니다.
(2) KV Cache 재사용 실험
약 65K Token의 동일한 Prompt를 두 차례 실행하여, 전체 Prefill을 다시 수행하는 경우와 CPU Memory에 저장된 KV Cache를 불러오는 경우의 TTFT(Time to First Token)를 비교했습니다.
| 구분 | 처리 방식 | TTFT |
|---|---|---|
| Prefill 전체 연산 | 약 65K Token 전체를 GPU에서 Prefill | 6.341초 |
| KV Cache Offload 활용 (저장소: CPU Memory) | CPU Memory에 저장된 KV Cache를 불러와 응답 | 0.495초 |
| 개선 결과 | 첫 응답 시간 5.846초 단축 | 12.8배 향상 |
이 실험에서 KV Cache Offload를 활용한 방식은 약 65K Token의 Prefill 전체 연산보다 TTFT가 12.8배 빨랐습니다. 장문 Prefix를 다시 계산하는 것보다 저장된 KV Cache를 불러오는 방식이 더 높은 응답 성능을 제공할 수 있음을 확인한 결과입니다. 다만 수치는 이번 내부 실험 환경에서 측정한 값으로, 모델 설정과 하드웨어·시스템 부하에 따라 달라질 수 있습니다.
(3) KV Cache 적용 현황
삼성SDS 추론 서비스는 임베딩·리랭킹·가드를 제외한 전 모델에 KV Cache Offload를 적용하고 있습니다. 적용 모델은 CPU Memory와 Local Disk까지 캐시 저장 범위를 확장하여 HBM에 남아 있지 않은 캐시도 다시 활용할 수 있도록 구성했습니다.
CPU Memory는 LRU(Least Recently Used) 방식으로 관리합니다. 할당된 용량이 부족해지면 가장 오랫동안 조회되지 않은 KV Cache부터 Eviction하여 새로운 캐시를 저장할 공간을 확보합니다. Local Disk는 사용률 85%를 관리 기준으로 두고, 기준에 도달하면 보관 중인 캐시 데이터를 Eviction하여 삭제합니다. 두 경우 모두 모델이나 원본 고객 데이터가 아니라, 필요하면 다시 계산할 수 있는 KV Cache 사본을 정리합니다.
Local Disk는 성능을 높이는 캐시 계층이며 서비스 실행의 필수 저장소로 사용하지 않습니다. Disk 장애나 교체로 저장된 캐시를 사용할 수 없으면 GPU 또는 CPU Memory의 캐시를 조회하고, Cache Miss 구간은 Prefill로 다시 계산합니다. 이에 따라 Disk Fault와 교체 과정에서도 요청 처리는 계속되도록 설계했으며, 캐시 적중률 저하에 따른 일시적인 성능 변화만 발생할 수 있습니다. 앞으로 출시하는 LLM도 서비스 배포 전에 Offload의 저장·복구 성능과 장애 시 우회 동작을 검증한 뒤 적용할 예정입니다.
내부 벤치마크에서 TPS(Tokens Per Second)는 12,259.87에서 22,683.09로 증가했습니다. 이는 약 1.85배, 즉 2배에 가까운 토큰 생산량입니다. 평균 TTFT는 22,394.14ms에서 7,314.89ms로 67.3% 감소했고, 평균 TPOT(Time Per Output Token)은 84.02ms에서 51.78ms로 38.4% 감소했습니다. 위 수치는 동일한 내부 벤치마크 워크로드로 적용 전·후를 비교한 결과이며, 요청 구성과 부하 조건에 따라 달라질 수 있습니다.
| 지표 | 적용 전 | 적용 후 | 변화 |
|---|---|---|---|
| TPS | 12,259.87 | 22,683.09 | 85.0% 증가(1.85배) |
| 평균 TTFT | 22,394.14ms | 7,314.89ms | 67.3% 감소 |
| P90 TTFT | 31,183.38ms | 14,514.40ms | 53.5% 감소 |
| P95 TTFT | 36,857.80ms | 21,247.19ms | 42.4% 감소 |
| 평균 TPOT | 84.02ms | 51.78ms | 38.4% 감소 |
| P90 TPOT | 141.86ms | 96.96ms | 31.7% 감소 |
| P95 TPOT | 199.67ms | 111.11ms | 44.4% 감소 |
실제 운영에서도 KV Cache Offload와 지난 아티클 「AI 추론 서비스의 관문, Inference Gateway」에서 소개한 Intelligent Routing을 함께 적용한 이후 토큰 처리량이 2배 이상 증가했으며, 2026년 8월 한 달 운영 기준으로 전체 Input에서 Cached Token이 차지하는 비중은 약 87%를 기록했습니다. 위 벤치마크와 운영 수치는 두 기술의 결합이 반복 Prefill을 줄이고 토큰 생산성을 높인 결과로 해석하는 것이 적절합니다.
KV Cache 적용에 따라 고객이 체감하는 핵심 가치
(1) 더 빠른 첫 응답
사용자가 LLM의 속도를 판단하는 첫 번째 기준은 답변 전체가 끝나는 시간이 아니라 첫 토큰이 나타나기까지의 시간인 TTFT(Time to First Token)입니다. 긴 시스템 프롬프트나 문서를 매번 다시 Prefill하면 사용자는 답변이 시작되기 전까지 기다려야 합니다. 캐시에 적중한 입력은 해당 구간의 계산을 생략할 수 있으므로, 특히 긴 공통 문맥을 사용하는 서비스에서 첫 응답을 앞당길 수 있습니다.
이 효과는 챗봇보다 복잡한 업무에서 더 크게 체감됩니다. 수십 페이지 문서를 바탕으로 연속 질문을 하거나, 코드 저장소의 구조를 읽힌 뒤 여러 작업을 요청하거나, AI 에이전트가 동일한 도구 설명과 업무 규칙을 반복해서 전달하는 경우가 대표적입니다. 첫 요청에서 생성한 캐시를 다음 요청에서도 사용할 수 있다면, 대화가 길어질수록 매번 전체 문맥을 다시 읽는 부담을 줄일 수 있습니다.
(2) 같은 GPU로 더 많은 고객 요청 수용
GPU가 같은 Prefix를 반복 계산하는 동안 다른 고객 요청은 대기합니다. 캐시 재사용은 단일 요청의 속도를 개선하는 데서 끝나지 않고, 절약된 Prefill 연산을 다른 요청 처리에 사용할 수 있게 합니다. 이는 동일한 GPU에서 분당 처리할 수 있는 토큰과, 서비스 품질 기준 안에서 수용할 수 있는 동시 요청을 늘리는 효과로 이어집니다.
(3) 사용량 증가를 비용 증가와 분리
LLM 서비스의 사용량이 늘면 일반적으로 GPU 증설이 뒤따릅니다. 그러나 증가한 토큰 중 상당 부분이 이미 처리했던 입력이라면 모든 증가분을 신규 연산으로 처리할 필요는 없습니다. KV Cache Offload는 GPU 외부의 상대적으로 저렴한 저장 자원을 활용해 Prefill 재계산을 줄임으로써, 요청 증가율보다 GPU 비용 증가율을 낮출 수 있는 가능성을 제공합니다. 이 절감은 고객 요금에도 직접 연결됩니다. 아래는 삼성SDS 추론 서비스에서 출시 예정 모델인 Qwen3.8-27B의 시장 가격 수준을 참고해 책정한 출시 예정 요금입니다. 금액은 백만 토큰당 원화 기준입니다.
| 모델 | 일반 Input | Cache Read | 절감률 |
|---|---|---|---|
| Qwen3.8-27B | 508원 | 73원 | 85.6% |
Cache Read 단가는 일반 Input의 약 14.4% 수준입니다. 따라서 캐시에 적중한 입력 토큰 하나는 일반 입력으로 처리할 때보다 약 85.6% 저렴하게 이용할 수 있습니다. 여기서 Cache Hit Ratio는 전체 Input Token 중 Cached Input으로 인정된 토큰의 비율로 계산하는 것이 정확합니다. 전체 입력 토큰을 T, Cache Hit Ratio를 H, 일반 Input 단가를 Pi, Cached Input 단가를 Pc라고 하면 입력 비용은 다음과 같습니다.
- 입력 비용 = T × {(1−H) × Pi + H × Pc}
- 입력 비용 절감률 = H ×(1 − Pc / Pi)
이 계산식에 Qwen3.8-27B 요금을 적용하면 Cache Hit Ratio가 높아질수록 다음과 같이 입력 비용이 줄어듭니다.
| Cache Hit Ratio | 백만 토큰 입력 비용 | 절감액 | 절감률 |
|---|---|---|---|
| 0% | 508.0원 | 0원 | 0% |
| 50% | 290.5원 | 217.5원 | 42.8% |
| 70% | 203.5원 | 304.5원 | 59.9% |
| 90% | 116.5원 | 391.5원 | 77.1% |
예를 들어 백만 Input Token 중 70%가 Cache Read로 처리되면 일반 Input 30만 토큰과 Cache Read 70만 토큰이 과금됩니다. 입력 비용은 508원에서 약 204원으로 감소하여 약 59.9%를 절감할 수 있습니다. 서비스 제공자는 캐시 재사용으로 줄어든 GPU 연산을 Cache Read 차등 요금으로 환원하고, 고객은 동일한 모델 품질을 더 낮은 입력 비용으로 이용할 수 있습니다.
(4) 피크 시간의 응답 품질 안정화
트래픽이 증가하면 평균 응답 시간보다 상위 지연시간(P95, P99)이 먼저 악화합니다. 일부 GPU에 긴 Prefill 요청이 몰리면 뒤따르는 요청이 대기하고, 캐시가 빠르게 교체되면서 재계산이 증가하는 악순환이 생깁니다. 캐시 용량을 외부 계층으로 확장하고 캐시 위치를 고려해 요청을 배치하면, 피크 시간에도 유효 캐시가 한꺼번에 사라지는 현상을 줄일 수 있습니다.
고객에게는 단순히 "평균적으로 더 빠른 서비스"보다 "업무가 몰릴 때도 응답 품질이 급격히 떨어지지 않는 서비스"가 더 중요한 가치가 될 수 있습니다. 따라서 KV Cache Offload의 효과는 평균 TTFT뿐 아니라 피크 시간대의 상위 응답 시간, 품질 기준 안에서 완료된 요청 수, 실패 및 재시도 비율로 함께 평가해야 합니다.
삼성SDS 추론 서비스에 적용된 KV Cache 확장 목표
현재 삼성SDS 추론 서비스에 적용된 KV Cache Offload는 노드 내부의 Pod 단위로 분리된 로컬 캐시를 사용합니다. 각 Pod는 계산이 완료된 KV Cache를 자신에게 할당된 CPU DRAM 또는 로컬 저장 영역에 비동기로 보관합니다. 이 구조는 단일 Pod의 캐시 수명을 늘리는 데는 효과적이지만, 같은 노드에서 동일 모델을 실행하는 다른 Pod가 동일한 Prefix를 처리하더라도 기존 캐시를 재사용할 수 없습니다. 요청이 다른 Pod로 라우팅되거나 Pod가 재시작되면 다시 Prefill해야 하며, 여러 Pod가 같은 KV Cache를 중복 보관하는 문제도 발생합니다.
| 단계 | 공유 범위 | 구성 | 기대 효과 |
|---|---|---|---|
| 현재 | Pod 내부 | Pod마다 독립된 CPU DRAM·로컬 저장 영역 사용 | 단일 Pod의 HBM 캐시 수명 연장 |
| 1단계 | 노드 내부 | 같은 노드의 여러 Pod가 공통 캐시 계층 공유 | 중복 저장 감소, 노드 내 Cache Hit Ratio 향상 |
| 2단계 | 노드 간 공유 | 여러 노드가 사용하는 분산 KV Cache Pool과 Cache-aware Routing 적용 | Pod·노드 변경과 스케일링 이후에도 캐시 재사용 범위 확대 |
| 장기 목표 | Prefill·Decode 분리 | Prefill과 Decode Pool을 독립적으로 운영하고 두 단계 사이에서 KV Cache 전송 | 워크로드별 독립 확장과 GPU 이용 효율 향상 |
먼저 노드 내 공유 단계에서는 동일 노드의 여러 모델 Pod가 CPU DRAM과 NVMe 캐시를 공통으로 사용할 수 있도록 구성합니다. 동일한 모델 버전과 토크나이저로 생성된 KV Cache를 노드 단위로 관리하면, 요청이 같은 노드의 다른 Pod로 전달되더라도 캐시를 다시 활용할 수 있습니다. 또한 Pod 롤링 업데이트나 일시적인 재시작 때도 캐시 저장 계층을 Pod 생명주기와 분리하여 Cold Cache 발생을 줄일 수 있습니다.
다음 단계는 노드 간 KV Cache 공유입니다. 특정 Pod나 노드에 캐시가 종속되지 않도록 여러 노드가 공통 캐시 Pool을 사용하고, Cache-aware Router가 필요한 Prefix를 보유한 Pod 또는 노드로 요청을 우선 전달하는 구조입니다. 이를 통해 Pod 교체와 노드 확장 이후에도 기존 캐시를 재사용할 수 있습니다.
노드 간 공유 저장 계층의 후보로는 WEKA와 CXL을 검토하고 있습니다. WEKA는 여러 GPU 서버가 동시에 접근할 수 있는 고성능 공유 파일시스템으로 대용량 KV Cache Pool을 구성하는 방안이며, CXL은 서버의 메모리 용량을 확장하거나 여러 연산 자원이 공유하는 메모리 계층을 구성하는 방안입니다. 실제 적용 방식은 Cache Hit Ratio, 전송 지연, 장애 격리와 비용을 함께 검증해 결정할 계획입니다.
장기적으로는 Prefill과 Decode를 서로 다른 GPU Pool에서 처리하는 P/D Disaggregation도 추진합니다. 긴 입력을 처리하는 Prefill Pool과 토큰을 생성하는 Decode Pool을 독립적으로 확장하고, 두 단계 사이에서 KV Cache를 전달하면 워크로드 특성에 맞춰 GPU를 배치할 수 있습니다. 노드 간 공유 Cache와 P/D Disaggregation을 결합하면 Prefill 결과를 여러 Decode 인스턴스가 활용하고, 트래픽 변화에 따라 각 Pool의 용량을 별도로 조정할 수 있습니다.
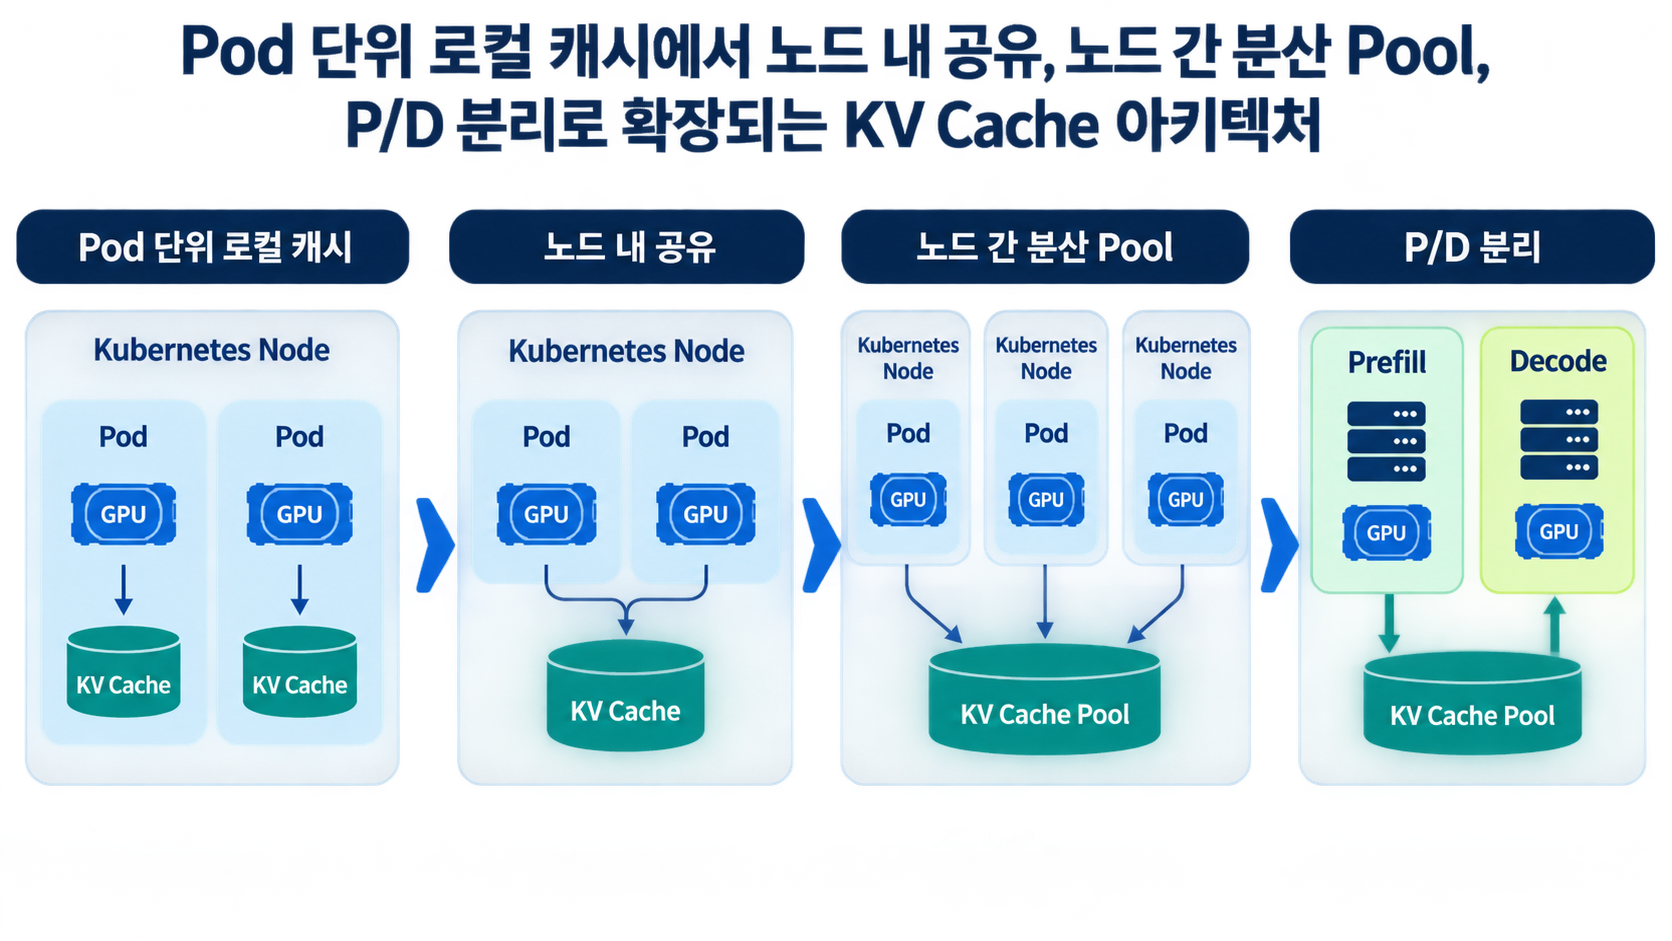 [그림4] Pod 단위 로컬 캐시에서 노드 내 공유, 노드 간 분산 Pool, P/D 분리로 확장되는 KV Cache 아키텍처 (출처: 삼성SDS)
Pod 단위 로컬 캐시에서 노드 내 공유, 노드 간 분산 Pool, P/D 분리로 확장되는 KV Cache 아키렉처
- 1.Pod 단위 로컬 캐시(Kubernetes Node[Pod-GPU]→KV Cache/[Pod-GPU]→KV Cache)
- 2.노드 내 공유(Kubernetes Node[Pod-GPU]+[Pod-GPU]→KV Cache)
- 3.노드 간 분산 Pool(Kubernetes Node[Pod-GPU]/[Pod-GPU]/[Pod-GPU]→KV Cache Pool)
- 4.P/D 분리(Prefill[GPU]→KV Cache Pool→Decode[GPU])
이 구조의 고객 가치는 장애 복구와 배포, 확장 과정에서도 응답 성능의 변동을 줄이는 데 있습니다. Pod가 교체되거나 트래픽 증가로 새로운 인스턴스가 추가되더라도 캐시가 특정 Pod와 함께 사라지지 않으므로, 축적된 Cache의 효과를 더 오래 유지할 수 있습니다. 여러 노드에서 동일한 Prefix를 다시 계산하는 비율이 줄어들면 전체 Cache Hit Ratio가 높아지고, 이는 더 빠른 TTFT와 더 많은 요청 수용량뿐 아니라 Cached Input으로 과금되는 토큰 비중의 증가로 연결됩니다.
기능 측면에서는 현재 시스템이 동일한 Prefix를 자동으로 찾아 재사용하는 암묵적 Cache를 적용하고 있습니다. 향후에는 고객이나 서비스가 재사용할 입력과 보존 범위를 직접 지정할 수 있는 명시적 Cache도 제공할 계획입니다. 이를 통해 반복 가능성이 분명한 대규모 프롬프트와 문서를 더 예측 가능하게 관리하고, 고객이 Cache Read 비용 절감 효과를 능동적으로 활용할 수 있도록 확장할 예정입니다.
여기까지가 캐시를 둘 공간을 넓히는 이야기입니다. 그런데 KV Cache를 아무리 효율적으로 관리해도, 요청이 없는 모델이 GPU에 계속 올라가 있다면 또 다른 비효율이 남습니다.
2. 쓰지 않는 시간을 되돌려받다 — Sleep/Wake
1장에서 다룬 것은 늘어나는 쪽의 문제였습니다. 요청이 길어지고 많아질수록 KV Cache가 부풀어 자리를 잠식하고, 그 반제품을 바깥 계층으로 내려놓아 작업대를 비웠습니다. 그런데 작업대를 다 비워도 라인에는 여전히 치울 수 없는 것이 남아 있습니다. 설비 그 자체, 즉 모델 가중치입니다.
GPU 메모리는 대략 세 덩어리로 나뉩니다. 트래픽과 무관하게 고정된 가중치, 요청에 따라 늘고 줄어드는 KV Cache 풀, 그리고 연산 중 임시로 쓰는 활성값·워크스페이스입니다. KV Cache Offload는 이 중 두 번째만 건드립니다. 첫 번째는 서버가 떠 있는 동안 1바이트도 줄지 않습니다. 8B 모델은 FP16으로 16GB, 70B는 140GB를 차지하고, 이 숫자는 초당 요청이 1000건일 때와 0건일 때가 똑같습니다.
문제는 실제 서비스의 요청이 고르게 들어오지 않는다는 점입니다. 사내 서비스는 업무 시간에 몰리고 야간과 주말에는 사실상 비어 있습니다. 하루 24시간 중 실제 부하가 걸리는 시간은 8시간 안팎입니다.
모델을 여러 개 올린 경우가 더 심합니다. 주 생성 모델, 임베딩 모델, 리랭커, 도메인별 파인튜닝 변형까지 같은 GPU에 상주시키면 가중치 합계만으로 HBM이 찹니다. KV Cache 풀에 줄 자리가 줄어들어, 1장에서 확보한 여유가 그대로 상쇄됩니다. 배치 파이프라인이나 평가·실험 워크로드는 하루에 한 번, 혹은 며칠에 한 번 돌아갑니다. 나머지 시간은 전부 유휴입니다.
그러면 안 쓸 때 내리면 되지 않을까요. 여기서 막힙니다. 프로세스를 종료하고 다시 띄우려면 가중치를 스토리지에서 읽어 올리고, CUDA 컨텍스트를 초기화하고, CUDA Graph를 캡처하고, 워밍업 요청을 흘려야 합니다. 70B급이면 수 분이 걸립니다. 첫 요청이 언제 올지 모르는 상황에서 감당하기 어려운 지연입니다. 그래서 현장의 선택은 대개 "그냥 띄워둔다"가 됩니다.
결과는 이런 모습입니다. 모니터링에서 GPU 연산 사용률은 5%인데 메모리 점유율은 90%입니다. 라인은 멈춰 있는데 설비가 바닥을 다 차지하고 있어서 다른 공정을 넣을 수 없습니다. 그리고 GPU는 연산량이 아니라 점유 시간으로 과금됩니다. 쓰지 않은 시간도 청구서에는 그대로 올라갑니다.
필요한 것은 "내리느냐 띄워 두느냐"의 양자택일이 아닙니다. 설비를 완전히 철거하지 않고 접어두었다가, 주문이 들어오면 빠르게 펴는 중간 상태입니다.
요청이 없는 시간에도 자리는 점유된다
기업용 AI 서비스에서 모든 모델이 24시간 동일한 트래픽을 받지는 않습니다. 업무 시간에만 쓰이는 모델, 하루 몇 차례만 호출되는 배치용 모델, 여러 모델을 올려두었지만 실제로는 그중 하나에만 요청이 몰리는 경우가 일반적입니다. 요청량은 이렇게 시간에 따라 크게 출렁이는데, 메모리 점유량은 출렁이지 않습니다. 모델이 한 번 올라가면 가중치는 요청이 1000건일 때나 0건일 때나 똑같은 자리를 차지합니다.
이 어긋남이 낭비의 정체입니다. 야간에 사내 모델이 한 건도 호출되지 않아도 16GB는 그대로 묶여 있고, 그 시간에 돌려야 할 배치 작업은 "메모리가 없다"는 이유로 시작하지 못합니다. 장부상으로는 만석이지만 실제로 일하는 자리는 없는 상태입니다.
1장의 문제와 나란히 놓으면 성격이 분명해집니다. 1장은 "자리가 실제로 부족했다"입니다. 작업대가 반제품으로 덮여 있었고, 그래서 반제품을 옆 창고로 내려놓아 공간을 넓혀 풀었습니다. 2장은 "자리는 차 있지만 아무도 일을 하지 않는다"입니다. 설비가 바닥을 점유한 채 멈춰 있고, 여기서는 내려놓을 반제품이 없습니다. 치울 것이 아니라 쓰지 않는 설비 자체가 자리를 잡고 있기 때문입니다.
그래서 해법의 방향도 달라집니다. 넓힐 공간이 더 없다면, 같은 공간을 시간으로 나눠 쓰는 수밖에 없습니다. 낮에는 A 모델이 그 자리를 쓰고, 밤에는 비워서 배치 작업에 넘기는 식입니다. 공장이라면 한 라인을 주간조와 야간조가 교대로 쓰는 것에 해당합니다. 문제는 교대에 걸리는 시간입니다. 라인을 철거하고 다시 짓는 데 몇 분이 걸린다면 교대는 성립하지 않습니다. 접어두고 펴는 동작이 충분히 빨라야 비로소 시간 분할이 현실적인 선택지가 됩니다.
Sleep과 Wake Up: 자원을 반환하고 되살리는 전환
앞서 말한 교대를 실제로 해보려면, 먼저 유휴 상태의 모델 서버가 정확히 무엇을 붙잡고 있는지 봐야 합니다.
저녁 7시, 사내 모델 서버에 요청이 끊깁니다. 모니터링에는 프로세스가 정상으로 뜨고, GPU 연산 사용률은 0%, 메모리 점유율은 90%입니다. 이때 선택지는 두 개뿐이었습니다. 그대로 두면 밤새 GPU 한 장이 아무 일도 하지 않고 청구됩니다. 프로세스를 죽이면 메모리는 돌아오지만, 아침 첫 요청이 수 분을 기다립니다. 둘 다 받아들이기 어렵습니다.
그런데 이 프로세스가 쥐고 있는 것들을 하나씩 떼어놓고 보면 성격이 다릅니다.
| 붙잡고 있는 것 | 크기 | 다시 만드는 비용 |
|---|---|---|
| 프로세스·파이썬 런타임·의존성 | 작음 | 수십 초 |
| CUDA 컨텍스트, 컴파일된 커널, CUDA Graph | 작음 | 수십 초~분 |
| 모델 가중치 | 매우 큼 (16~140GB) |
수십 초(스토리지 읽기) |
| KV Cache 풀 | 큼 | 없음(그냥 비우면 됨) |
핵심은 자리를 많이 차지하는 것과 다시 만들기 어려운 것이 서로 다르다는 점입니다. 프로세스를 죽이는 방식은 이 둘을 구분하지 않고 전부 버리기 때문에 비쌉니다. 비싼 것은 크지 않고, 큰 것은 그렇게까지 비싸지 않습니다. 그렇다면 다시 만들기 비싼 것은 그대로 남겨두고, 자리만 많이 차지하는 것들을 반환하면 됩니다.
Sleep/Wake Up이 바로 이 구분을 제도화한 것입니다. 일정 시간 요청이 없는 모델을 Sleep 상태로 전환하면, 프로세스와 CUDA 컨텍스트·컴파일 결과는 살려 둔 채 가중치와 KV Cache 풀을 HBM에서 비워 GPU 자원의 대부분을 반환합니다. 다시 요청이 들어오면 Wake Up으로 가중치를 되돌려 활성 상태로 복귀합니다. 재기동이 수 분인 자리에서 복귀가 수 초 수준으로 내려오고, 그 차이가 "밤에는 비워둔다"를 현실적인 운영 방식으로 만듭니다.
반환의 깊이는 선택할 수 있습니다. 가중치를 CPU DRAM에 내려 두면 복귀가 가장 빠르지만 호스트 메모리를 소모하고, 아예 폐기하면 GPU·CPU 메모리를 모두 비우는 대신 복귀 시 스토리지에서 다시 읽어야 합니다. 얼마나 오래 잘 것인지에 따라 고르는 문제입니다.
이 방식의 효과는 여러 모델을 하나의 GPU Pool에서 함께 운영할 때 가장 크게 나타납니다. 왜 그런지는 지금까지의 일반적인 구조와 비교하면 분명해집니다.
기존에는 모델마다 GPU를 고정으로 배정했습니다. A 모델에 1번 GPU, B 모델에 2번 GPU를 붙여놓는 식입니다. 이 구조에서 배정량은 피크 트래픽을 기준으로 잡아야 합니다. 가장 바쁜 순간을 버텨야 하니까요. 문제는 피크가 하루 중 잠깐이라는 점입니다. 나머지 시간의 GPU는 자기 모델만 기다리며 놀지만, 옆 모델이 바빠도 그 자리를 빌려줄 수 없습니다. 자리가 모델에 묶여 있기 때문입니다.
예를 들어 사내에 이런 모델 다섯 개가 있다고 해 봅시다.
| 모델 | 실제 사용 시간 |
|---|---|
| A. 사내 챗봇 | 평일 09~18시 |
| B. 문서 요약 | 평일 09~18시 |
| C. 야간 배치 분류 | 매일 02~04시 |
| D. 검색 리랭커 | 종일, 저부하 |
| E. 평가·실험용 | 주 2회, 몇 시간 |
고정 할당이라면 GPU 5장이 필요합니다. 그런데 실제로 동시에 일하는 모델은 몇 개일까요. 낮에는 A·B·D 셋이고, 새벽에는 C 하나뿐이며, E는 대부분의 시간 동안 아무것도 하지 않습니다. 다섯 개를 다 깨워 둘 필요가 있는 순간은 존재하지 않습니다.
Sleep/Wake Up을 쓰면 자리를 모델에 고정하지 않고 그 시각에 실제로 요청을 처리하는 모델에게 내줄 수 있습니다. 낮에는 C와 E가 Sleep 상태로 메모리를 비우고 A·B·D가 자리를 씁니다. 새벽 2시가 되면 A·B가 잠들고 C가 깨어나 같은 자리를 이어받습니다. 결과적으로 GPU 3장으로 모델 다섯 개를 서비스할 수 있습니다. 앞 절의 표현을 다시 쓰면, 같은 공간을 시간으로 나눠 쓰는 것입니다.
운영 관점에서 더 의미 있는 변화는 GPU 절감보다 "올릴 수 있는 모델의 수"입니다. 지금까지는 호출 빈도가 낮은 모델을 서비스에 등록하려면 GPU를 새로 확보해야 했고, 그래서 "쓸 데는 있지만 전용 GPU를 붙일 만큼은 아닌" 모델들이 계속 대기 상태로 남았습니다. 트래픽 편차가 큰 모델을 여러 개 운영하는 환경이라면, 이제 GPU를 늘리지 않고도 이런 모델들을 서비스 목록에 올릴 수 있습니다.
물론 전제가 있습니다. 여러 모델의 피크가 겹치면 Wake Up 경합이 생기므로, 시간대가 실제로 어긋나는지 확인해야 합니다. 어떤 모델을 언제 재우고 깨울지 판단하는 오케스트레이션 계층도 필요합니다.
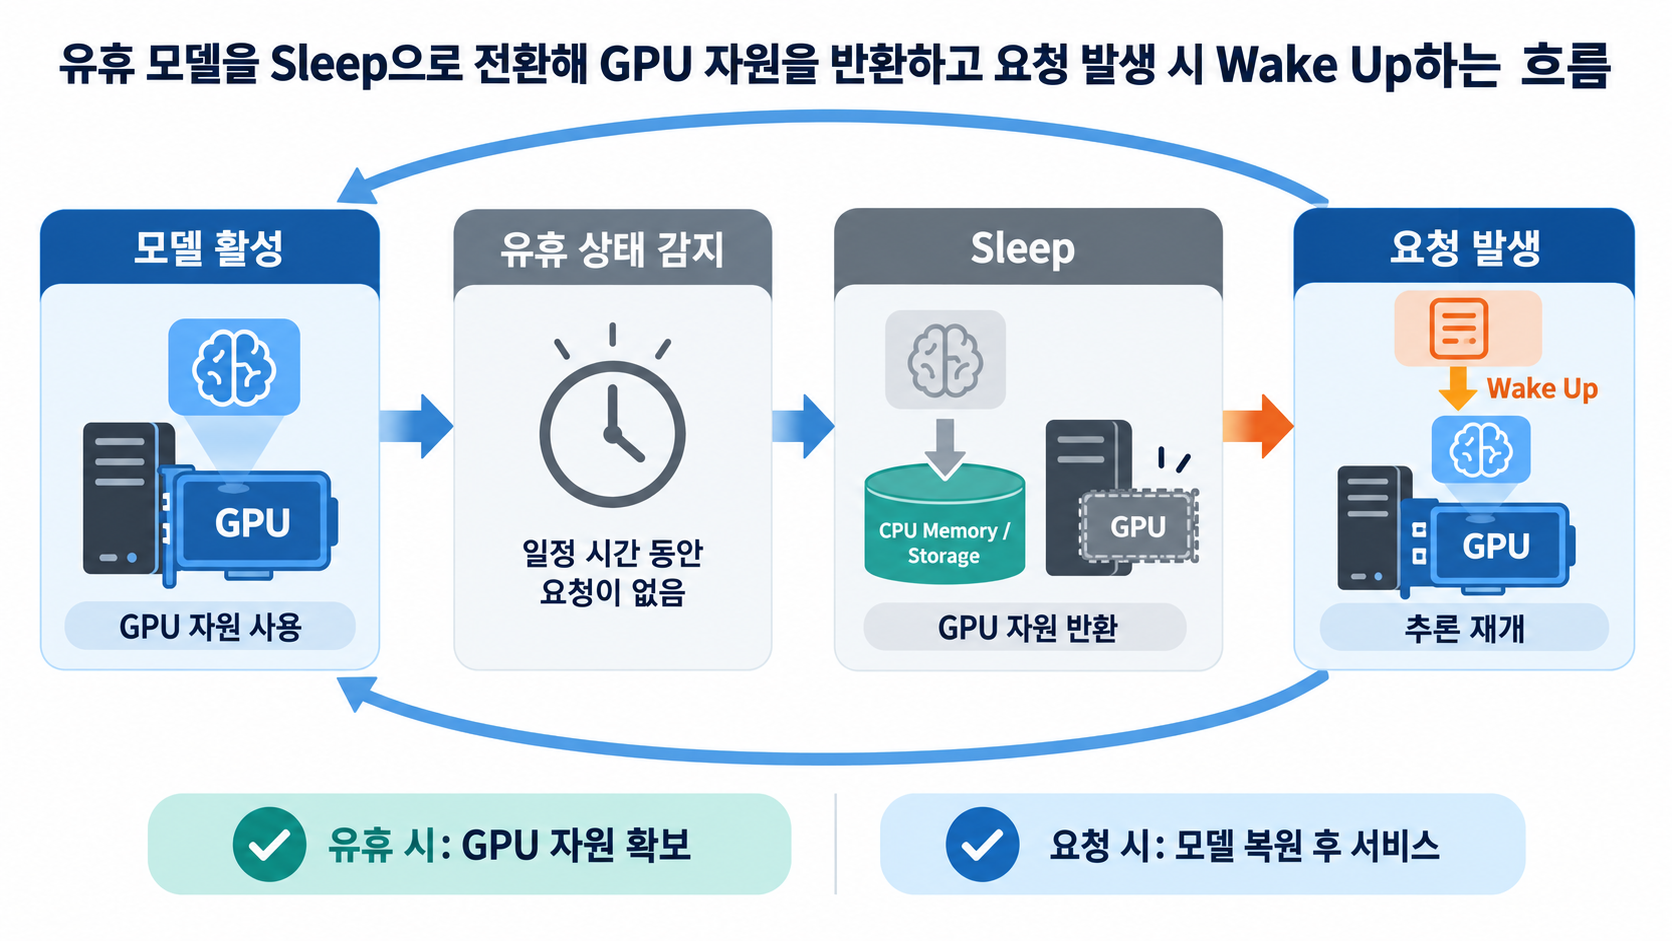 [그림5] 유휴 모델을 Sleep으로 전환해 GPU 자원을 반환하고 요청 발생 시 Wake Up하는 흐름 (출처: 삼성SDS)
유휴 모델을 Sleep으로 전환해 GPU 자원을 반환하고 요청 발생 시 Wake Up하는 흐름
\모델 활성(GPU 자원 사용) → 유휴 상태 감지(일정 시간 동안 요청이 없음) → Sleep(GPU 자원 반환) → 요청 발생(Wake Up-추론 재개) → 모델 활성으로 반복
요청 시: 모델 복원 후 서비스, 유휴 시: GPU 자원 확보
반환된 메모리를 실제로 쓰게 만드는 조건
다만 자원을 반환한다고 해서 다른 모델이 곧바로 그 자원을 쓸 수 있는 것은 아닙니다. 대부분의 서빙 엔진은 기동 시점에 KV Cache 영역을 크게 선점해 두는 방식으로 동작하기 때문입니다. 반환된 메모리를 다른 모델이 실제로 쓸 수 있으려면, KV Cache 영역을 탄력적으로 할당·회수하는 Controller 계층이 함께 필요합니다. 최근에는 GPU 가상 메모리를 기반으로 이 문제를 다루는 kvcached 같은 오픈소스 접근도 등장하고 있습니다.
물론 Wake Up에는 모델을 다시 사용 가능한 상태로 만드는 시간이 필요합니다. 어떤 모델을 언제 Sleep으로 전환하고 어느 수준까지 자원을 반환할지는 서비스의 Latency 요구사항과 트래픽 패턴을 함께 고려해 설계해야 합니다.
여기까지가 GPU 메모리를 소프트웨어로 다루는 두 가지 방법입니다. 공간을 넓히고, 시간으로 나눕니다. KV Cache Offload는 작업대 위의 반제품을 바깥 계층으로 내려 자리를 만들었고, Sleep/Wake Up은 같은 자리를 시간대별로 번갈아 쓰게 만들었습니다.
두 방법은 접근이 전혀 다르지만, 한 가지를 공유합니다. 둘 다 GPU 한 장의 HBM 용량을 상수로 놓고 그 안에서 배치와 순서를 바꾼 것입니다. 80GB는 80GB로 두고, 무엇을 남기고 무엇을 내보낼지, 언제 누가 쓸지를 재조정했을 뿐입니다. 제약 자체는 한 번도 건드리지 않았습니다.
그래서 이 방식들은 같은 지점에서 한계를 만납니다. Offload는 대역폭에 막힙니다. HBM이 3.3TB/s인데 바깥으로 나가는 길은 32GB/s입니다. 옮길 양이 늘어나면 절약한 메모리보다 전송 지연이 먼저 비용이 됩니다. Sleep/Wake Up은 시간대가 어긋날 때만 유효합니다. 여러 모델의 피크가 겹치면 재울 대상이 없습니다. 교대는 근무 시간이 다를 때만 성립합니다. 그리고 둘 다, 어느 한 순간에 동시에 필요한 양이 HBM을 넘어서면 할 말이 없습니다. 배치도 순서도 총량을 늘리지는 못합니다.
이 벽에 부딪혔을 때 지금까지의 답은 하나였습니다. GPU를 더 사는 것입니다. 그런데 이 답에는 처음부터 이상한 점이 있었습니다. 우리가 부족한 것은 연산이 아니라 메모리인데, 사고 있는 것은 연산 성능 기준으로 값이 매겨진 하드웨어입니다. 1장 도입부의 상황이 그대로 재현됩니다. 기계는 절반쯤 놀고 있는데, 라인을 늘리려고 기계를 한 대 더 들이는 것입니다.
이쯤에서 질문의 층위가 바뀝니다. 지금까지는 "주어진 메모리를 어떻게 더 잘 쓸까"를 물었습니다. 소프트웨어로 답할 수 있는 질문이었고, 실제로 상당한 여유를 만들어냈습니다. 하지만 짜낼 것을 다 짜낸 다음에 남는 질문은 다릅니다. 연산과 메모리의 비율이 애초에 다르게 설계된 하드웨어를 쓰면 되지 않을까?
이것은 최적화 문제가 아니라 선택의 문제입니다. 그리고 이 선택지가 실제로 존재한다는 것이 다음 장의 주제입니다.
3. 계층을 옮기다 — NPU 기반 경제적 AI 추론
앞 장의 질문은 이것이었습니다. 연산과 메모리의 비율이 다르게 설계된 하드웨어를 쓰면 되지 않을까. 이 질문이 성립하는 이유는, 지금 쓰고 있는 GPU가 추론을 위해 설계된 물건이 아니기 때문입니다.
토큰을 하나 생성하는 과정을 들여다보면 이유가 보입니다. Decode 단계에서 모델은 다음 토큰 하나를 만들기 위해 가중치 전체를 HBM에서 한 번 읽습니다. 8B 모델이면 16GB를 읽고, 그 데이터로 수행하는 연산은 16 GFLOPs 정도입니다. 읽은 바이트당 연산량이 극히 적습니다. H100의 HBM 대역폭 3.3TB/s를 다 쓴다고 해도 초당 200토큰 남짓이고, 그때 텐서코어가 하는 일은 이론 성능의 1%에도 미치지 못합니다. GPU 값의 대부분을 차지하는 연산 유닛이 사실상 놀고 있는 것입니다.
이것을 메우는 방법이 배치입니다. 요청을 여러 개 묶어 한 번 읽은 가중치로 여러 토큰을 만들면 연산 밀도가 올라갑니다. 그런데 배치를 키우려면 KV Cache를 놓을 자리가 필요합니다. 1장과 2장에서 우리가 한 일이 결국 이것이었습니다. 메모리를 짜내 배치를 키우고, 그렇게 해서 비싼 연산 유닛을 조금이라도 더 쓰는 것. 다만 그 노력에는 앞서 본 천장이 있었습니다.
그러니 상황을 정리하면 이렇습니다. 추론 워크로드가 정말로 원하는 것은 큰 메모리와 넓은 대역폭이고, 우리가 값을 치르고 있는 것은 대규모 연산 성능입니다. 학습과 그래픽스를 위해 만들어진 하드웨어를 추론에 쓰고 있으니 당연한 결과입니다. 여기서 "추론 전용 가속기"라는 말의 의미가 분명해집니다. 연산 유닛에 배정된 예산을 줄이고, 그 예산을 메모리 용량·대역폭·전력 효율로 옮긴 설계입니다.
그런데 이 어긋남은 몇 년 전에도 있었습니다. 왜 지금 문제가 되는가 하면, 원가가 곧 경쟁력이 되는 국면에 들어섰기 때문입니다. 생성형 AI가 시범 단계를 지나 상시 서비스로 넘어오면서, 추론 비용은 한 번 쓰고 끝나는 개발비가 아니라 매달 반복되는 운영비가 되었습니다. 특히 토큰 단위로 값을 매기는 시장에서는 원가 구조가 그대로 가격 경쟁력이 됩니다.
분모를 키우는 일이 1장과 2장이었습니다. 이제 남은 것은 분자입니다. 같은 품질의 응답을 더 낮은 단가로 낼 수 있다면 그것은 마진이 아니라 점유율의 문제가 되고, 그래서 하드웨어 선택은 인프라 팀의 기술 결정을 넘어 사업의 문제로 올라옵니다. 전력과 랙 공간, 그리고 조달 리드타임까지 계산에 들어옵니다.
추론 전용으로 설계된 가속기
생성형 AI 시장이 급속도로 성장하면서 추론 서비스의 경제성이 서비스 제공자의 경쟁력을 좌우하는 핵심 요소로 떠올랐습니다. 특히 토큰 기반 가격 모델에서 같은 성능의 서비스를 낮은 가격으로 제공할 수 있다면, 이는 곧 시장 점유율 확대로 직결됩니다.
NPU(Neural Processing Unit)는 AI 모델의 학습(Training)이 아닌 추론(Inference) 작업에 특화된 전용 가속기입니다. 일반적인 GPU는 그래픽 처리와 AI 학습, 추론을 모두 아우르도록 설계되어 전력 소비가 높은 반면, NPU는 추론이라는 단일 목적으로 최적화되어 있습니다.
NPU의 핵심 가치는 세 가지로 정리됩니다. 첫째, 전력 효율성입니다. LLM 추론 처리에서 NPU는 GPU 대비 크게 낮은 전력을 소비하며, 이는 데이터센터의 전력 비용을 절감합니다. 둘째, 낮은 지연시간과 높은 처리량의 균형입니다. 추론에 필요한 연산만을 수행하도록 설계되어, 같은 전력 예산 내에서 더 많은 토큰을 처리할 수 있습니다. 셋째, 비용 효율성입니다. 저전력 설계는 냉각 시스템과 전력 공급 장비의 규모를 줄여 총소유비용(TCO)을 감소시킵니다. 이는 곧 토큰 가격 인하로 이어져 추론 서비스 제공자의 경쟁력을 높입니다.
퓨리오사AI RNGD: 텐서 축약 프로세서 기반 설계
퓨리오사AI의 RNGD(Renegade) NPU는 국내에서 개발한 2세대 추론 전용 가속기로, 텐서 축약 프로세서(TCP, Tensor Contraction Processor) 아키텍처를 기반으로 설계되었습니다.
TCP 아키텍처는 행렬 곱셈(Matrix Multiplication)과 같은 신경망 핵심 연산을 높은 효율로 처리하도록 설계되었으며, 범용성과 전력 효율의 균형을 지향합니다. 메모리 계층은 48GB의 HBM3E를 탑재하여 Llama 3.1 8B와 같은 모델을 단일 카드에서 배포할 수 있고, 전력 소비는 150W TDP(Thermal Design Power)로 제한됩니다. 고성능 학습용 GPU가 카드 단위로 수백 W에서 1,000W 이상을 소비하는 것과 대비되는 지점입니다.
퓨리오사AI에 따르면 이러한 저전력 설계 덕분에 RNGD는 같은 규모의 랙 내에서 GPU 대비 수 배의 토큰 처리 성능을 제공할 수 있습니다. 같은 면적의 데이터센터에서 더 많은 사용자 요청을 처리할 수 있다는 의미이며, 토큰당 비용을 낮추는 직접적인 요인이 됩니다. 또한 TCP 아키텍처를 위해 설계된 전용 컴파일러는 다양한 신경망 구조에 대한 프로그래밍 유연성을 제공하면서도 성능을 최대화하는 것을 목표로 합니다.
리벨리온 RebelServer: 서버 단위로 완결되는 추론
NPU가 데이터센터 추론용 가속기로 자리 잡기 위해서는 단순히 연산 성능만 높이는 것으로는 충분하지 않습니다. 실제 운영 환경에서는 대형 모델을 여러 가속기에 어떻게 분산할 것인지, 서버 간 통신 비용을 어떻게 줄일 것인지, 기존 GPU 중심의 추론 소프트웨어를 얼마나 그대로 사용할 수 있는지가 함께 해결되어야 합니다. 리벨리온의 RebelServer는 이러한 NPU 도입 장벽을 서버 아키텍처와 소프트웨어 스택을 함께 설계하는 방식으로 풀어가고 있습니다.
리벨리온(Rebellions)의 RebelServer는 Rebel100 칩을 탑재한, 대규모 언어 모델 및 멀티모달 모델 추론에 특화된 데이터센터 서버입니다. Rebel100 칩은 멀티노드 확장을 염두에 두고 설계되어, 단일 서버만으로도 고성능 GPU 서버에 준하는 처리 능력을 제공하는 것을 목표로 합니다. 초거대 모델 연산이 하나의 서버 내에서 완결되면 서버 간 통신 부담이 줄어들고, 데이터센터 구축 비용과 운영 부담도 함께 낮아집니다.
주목할 부분은 소프트웨어 생태계입니다. vLLM의 핵심 어텐션 메커니즘이 NPU 상에서 네이티브하게 실행되도록 재설계되었으며, FlashAttention과 PagedAttention은 하드웨어와 공동 설계되어 단일 런타임으로 통합됩니다. vLLM, Triton 등 주요 오픈소스 추론 프레임워크와의 호환성을 확보하여 개발자들은 기존 개발 환경과 API를 그대로 활용할 수 있습니다. 이는 기존 NVIDIA 기반 시스템에서 리벨리온 NPU로의 코드 마이그레이션 부담을 낮춰 벤더 락인(Vendor Lock-in)을 피할 수 있게 합니다.
또한 RSD(Rebellions Scalable Design)를 통해 단일 디바이스를 넘어 멀티 노드·멀티 카드 환경으로 LLM 서빙을 확장할 수 있으며, Prefill 분리와 Mixture of Experts(MoE) 라우팅 등 최신 추론 기법을 지원합니다. 1장에서 살펴본 P/D Disaggregation이 하드웨어 벤더의 로드맵에서도 함께 다뤄지고 있다는 점은, 이 방향이 특정 스택의 선택이 아니라 추론 인프라의 공통 과제가 되고 있음을 보여줍니다.
국산 NPU와 독자 파운데이션 모델: 풀스택 소버린 AI
NPU 기술은 파운데이션 모델과 결합될 때 활용 범위가 더욱 확대됩니다. 모델과 AI 반도체, 추론 소프트웨어, 서비스 플랫폼까지 연계할 수 있다면 특정 기술 계층에 국한되지 않고 전체 AI 서비스 스택을 최적화할 수 있기 때문입니다.
국내에서도 이러한 풀스택 AI 구현 사례가 등장하고 있습니다. 업스테이지, 카카오, 퓨리오사AI 등이 협력하여 국산 NPU와 독자 개발 파운데이션 모델을 연계한 서비스를 상용화했고, SKT가 자체 개발한 파운데이션 모델 ‘A.X K1’을 리벨리온의 RebelServer에서 구동하는 구성도 실증되었습니다. 이는 국내에서 개발된 AI 반도체와 파운데이션 모델을 결합해 실제 추론 서비스를 구성할 수 있음을 보여주는 사례입니다. 또한 리벨리온의 제품이 과학기술정보통신부 혁신제품으로 지정되어 공공 부문에서의 도입 경로가 확대되고 있다는 점도 국내 NPU 생태계가 실증과 상용화 단계로 진입하고 있음을 보여줍니다
이러한 조합의 의미는 크게 세 가지로 볼 수 있습니다.
첫째, 기술 선택권과 공급망 다변화입니다. 국산 NPU와 국내에서 개발된 파운데이션 모델은 기존 글로벌 GPU·모델 중심의 선택지에 추가적인 대안을 제공합니다. 이는 특정 해외 기업에 대한 의존도를 단순히 국내 기업으로 이전한다는 의미가 아니라, GPU와 NPU, 글로벌 모델과 국내 모델 등 다양한 기술을 필요에 따라 선택할 수 있는 구조를 만드는 데 의미가 있습니다. 특히 하드웨어와 모델, 추론 소프트웨어를 함께 최적화할 수 있다면 특정 벤더에 종속되는 위험을 줄이고 서비스 특성에 적합한 기술 조합을 선택할 수 있습니다.
둘째, 국내 AI 생태계와 기술 스택의 확장입니다. 국내 NPU 기업의 경쟁력을 비용 우위라는 관점에서 단순 평가하기보다는, 기존 GPU 중심의 AI 인프라에 새로운 선택지를 제공한다는 점에 주목할 필요가 있습니다. NPU, 파운데이션 모델, 추론 엔진, 클라우드 플랫폼이 연계되면 국내 기업 간 기술 협력과 공동 최적화가 가능해지고, 특정 워크로드에 특화된 AI 서비스 아키텍처를 구축할 수 있는 기반도 확대됩니다. 이는 국내 AI 산업이 반도체나 모델과 같은 개별 기술을 넘어 전체 서비스 스택으로 확장되는 데 의미가 있습니다.
셋째, 데이터 및 운영 통제 범위의 확대입니다. 데이터 주권은 단순히 국산 기술을 사용하거나 국내 데이터센터에서 서비스를 운영한다고 해서 자동으로 확보되는 것은 아닙니다. 글로벌 클라우드 사업자 역시 국내 리전과 AZ를 활용하여 데이터를 국내에서 저장·처리하도록 구성할 수 있습니다. 따라서 중요한 것은 기술의 국적보다는 데이터 저장 위치, 운영 주체, 법적 관할권, 데이터 접근 정책, 모델 및 인프라에 대한 통제 수준입니다. 국산 NPU와 자체 또는 국내에서 운영 가능한 모델은 이러한 요소를 조직이 직접 설계하고 통제할 수 있는 선택지를 확대한다는 점에서 의미가 있습니다.
토큰 기반의 추론 서비스에서는 하드웨어 가격뿐 아니라 전력 소비량, 모델별 처리량, GPU 또는 NPU 활용률, 메모리 용량과 대역폭, 배치 크기 등의 요소가 최종 토큰당 비용(Cost per Token)에 영향을 미칩니다. 따라서 퓨리오사AI RNGD나 리벨리온 RebelServer가 기존 GPU 대비 비용을 절감할 수 있다고 평가하려면 동일 모델과 동일 서비스 수준을 기준으로 한 Throughput(token/s), 전력 소비량(W), 장비 가격 및 시간당 비용, Cost per Million Tokens 등의 정량적인 비교가 필요합니다. 이러한 지표가 확보될 경우에만 특정 워크로드에서의 비용 효율성을 객관적으로 평가할 수 있습니다.
또한 국산 NPU와 독자 파운데이션 모델을 결합했다고 해서 모두 소버린 AI로 볼 수 있는 것은 아닙니다. 소버린 AI는 모델의 개발 주체뿐 아니라 학습·추론 인프라, 데이터 관리, 운영 소프트웨어, 거버넌스 등에 대한 실질적인 통제권을 함께 고려해야 하는 개념입니다. 따라서 GPU 메모리 병목과 추론 효율화라는 관점에서는 국산 NPU를 GPU 중심 인프라의 대안 또는 보완 수단으로 보는 것이 적절하며, 소버린 AI는 이러한 기술이 데이터·모델·인프라 전반에 대한 통제 체계와 결합될 때 얻을 수 있는 확장된 가치로 구분해 설명하는 것이 타당합니다.
4. 세 기술이 한 스택에서 만나는 지점
세 기술은 서로 다른 문제를 해결하지만, 실제 추론 서비스에서는 하나의 자원 관리 스택 안에서 연결됩니다. KV Cache Offload는 이미 계산한 결과를 어디에 보관할 것인지, Sleep/Wake는 GPU 메모리를 언제 점유하고 반환할 것인지, NPU는 추론 워크로드를 어떤 가속기에서 처리할 것인지를 다룹니다. 즉, 각각 공간·시간·하드웨어라는 서로 다른 축에서 GPU 메모리와 연산 자원의 활용 방식을 최적화합니다.
이 세 가지를 함께 살펴봐야 하는 이유는 실제 서비스에서 GPU 메모리 병목이 하나의 원인으로 발생하지 않기 때문입니다. 캐시가 GPU 메모리를 차지하고, 사용 빈도가 낮은 모델이 자원을 계속 점유하며, 모든 추론 워크로드를 GPU에 배치하는 구조가 동시에 자원 효율에 영향을 줍니다. 따라서 캐시의 배치, 모델의 활성 상태, 연산을 수행할 가속기 선택을 하나의 자원 관리 문제로 바라볼 필요가 있습니다. [표 9]는 이러한 관점에서 세 기술이 각각 어떤 축을 담당하는지 정리한 것입니다.
| 기술 | 다루는 축 | 핵심 질문 | 얻는 것 |
|---|---|---|---|
| KV Cache Offload | 공간 | 캐시를 어디에 둘까 | 계산 결과의 수명 연장, Prefill 재계산 감소 |
| Sleep/Wake | 시간 | 그 자리를 언제 쓸까 | 유휴 모델이 점유한 자원의 회수 |
| NPU | 하드웨어 | 애초에 무엇 위에 올릴까 | 전력·랙 단위 효율과 토큰당 비용 개선 |
이처럼 서로 다른 축을 담당하는 기술을 하나의 추론 스택에서 연계하면 각 기술을 개별적으로 적용했을 때보다 자원을 보다 유연하게 활용할 수 있으며, 기술 간 상호 보완 효과도 기대할 수 있습니다.
KV Cache Offload와 Sleep/Wake는 서로를 보완합니다. Sleep/Wake를 적용하면 유휴 모델이 점유하던 GPU 메모리를 반환할 수 있지만, Wake Up 이후 캐시가 모두 사라진 상태라면 초기 요청에 대해 다시 Prefill을 수행해야 합니다. 반면 KV Cache 저장 계층이 개별 Pod의 생명주기와 분리되어 있다면 모델이 Sleep 상태로 전환된 이후에도 기존 캐시를 유지할 수 있습니다. 이후 모델이 다시 활성화되었을 때 저장된 캐시를 재사용함으로써 Wake Up 이후 발생할 수 있는 Prefill 부담을 줄일 수 있습니다. 따라서 앞서 살펴본 노드 내·노드 간 공유 KV Cache 구조는 Sleep/Wake의 효과를 높이는 기반 기술이 될 수 있습니다.
KV Cache Offload와 Intelligent Routing도 긴밀하게 연결됩니다. 캐시를 외부 계층으로 확장하면 단순히 캐시를 저장하는 것만으로는 충분하지 않습니다. 요청과 연관된 KV Cache가 어느 노드 또는 어느 저장 계층에 존재하는지를 파악하고, 가능한 한 해당 캐시를 활용할 수 있는 인스턴스로 요청을 전달해야 하기 때문입니다. 즉, 캐시의 위치를 관리하는 문제와 요청의 목적지를 결정하는 문제는 함께 고려되어야 합니다. SAI 운영에서 토큰 처리량이 2배 이상 증가하고 Cached Token 비중이 약 87%에 도달한 사례 역시 저장 계층 확장과 Intelligent Routing을 함께 적용한 결과로 볼 수 있습니다.
NPU는 이러한 구조와 별개로 동작하는 대체재라기보다 이종 가속기 자원 풀을 구성하는 하나의 선택지가 될 수 있습니다. 예를 들어 GPU 노드와 NPU 노드가 동일한 추론 플랫폼에 참여하고 공유 KV Cache 계층을 사용할 수 있다면, 스케줄러는 요청 특성과 모델 지원 여부, 캐시 위치, 가속기 가용량 등을 함께 고려해 실행 위치를 결정할 수 있습니다.
특히 Prefill과 Decode는 연산 특성과 메모리 사용 패턴이 다르기 때문에 향후에는 각 단계를 동일한 종류의 가속기에서 처리해야 한다는 전제에서 벗어나, 워크로드 특성에 따라 GPU와 NPU를 어떻게 배치하고 조합할 것인지가 새로운 스케줄링 과제로 등장할 수 있습니다. 결국 GPU 메모리 병목을 완화하는 문제는 개별 최적화 기술을 적용하는 것을 넘어, 캐시·모델·가속기를 하나의 자원 풀로 관리하고 요청마다 적절한 실행 위치를 선택하는 방향으로 확장될 수 있습니다.
다음 판단들
GPU 메모리를 다루는 방식은 단순히 메모리 사용량을 줄이는 것에서 점차 전체 추론 자원을 어떻게 배치하고 운영할 것인가의 문제로 확장되고 있습니다. 초기에는 KV Cache를 외부로 내리거나 유휴 모델의 메모리를 반환하는 것처럼 GPU 메모리 자체를 확보하는 데 초점이 맞춰졌다면, 이제는 확보한 자원을 언제 사용할지, 캐시를 누가 어떤 기준으로 관리할지, 어떤 가속기에 요청을 배치할지까지 함께 고려하는 단계로 발전하고 있습니다.
즉, 관리의 범위가 메모리 용량 최적화에서 GPU 가동률, 캐시 운영 정책, 이종 가속기 간 자원 배치로 넓어지고 있는 것입니다. 이러한 변화는 다음 세 가지 축에서 구체적으로 나타납니다.
가동률 제고를 위한 배치 추론이 첫 번째 축입니다. Sleep/Wake를 통해 유휴 모델이 점유하던 GPU 자원을 회수하더라도, 해당 자원을 실제 워크로드에 활용하지 못한다면 전체 자원 효율은 크게 높아지지 않습니다. 즉시 응답이 필요하지 않은 요청을 일정량 모아 유휴 시간대에 처리하면, 실시간 트래픽이 적은 시간에도 GPU를 활용할 수 있습니다. 이에 따라 실시간 요청과 배치 요청을 동일한 GPU Pool에서 운영하되, 서비스 중요도와 응답 요구 수준에 따라 우선순위를 구분하여 스케줄링하는 방식이 중요한 검토 대상이 됩니다.
명시적 Cache는 캐시 관리의 범위를 시스템 내부 최적화에서 사용자 또는 서비스 정책 영역으로 확장하는 두 번째 축입니다. 현재의 암묵적 Cache가 시스템이 입력의 중복 여부를 판단하고 자동으로 캐시를 탐색·재사용하는 방식이라면, 명시적 Cache는 고객이 재사용할 입력과 캐시 유지 범위, 수명 등을 직접 지정하는 방식입니다. 이를 통해 반복이 명확한 대규모 프롬프트를 보다 예측 가능하게 관리할 수 있고, Cache Read 활용률과 비용 절감 효과를 서비스 특성에 맞게 설계할 수 있습니다.
이종 가속기 스케줄링은 자원 관리의 대상을 GPU 내부에서 GPU와 NPU를 포함한 전체 가속기 Pool로 확장하는 세 번째 축입니다. GPU와 NPU가 동일한 서비스 환경에 공존하게 되면, 단순히 사용 가능한 GPU를 선택하는 것을 넘어 요청 특성, 모델 지원 여부, 지연시간 요구사항, 처리량, 메모리 사용 패턴 등을 기준으로 적합한 가속기를 선택해야 합니다. 기존 추론 라우팅이 주로 “어떤 모델 또는 어떤 인스턴스로 보낼 것인가”를 결정하는 문제였다면, 앞으로는 “이 요청을 어떤 종류의 가속기에서 처리할 것인가”라는 판단까지 포함하게 됩니다.
결국 GPU 메모리 최적화의 범위가 넓어진다는 것은 메모리 공간을 확보하는 기술에서 출발해, 확보한 자원을 언제 활용할지, 캐시를 어떤 정책으로 관리할지, 어떤 가속기에 워크로드를 배치할지까지 추론 자원 전반을 통합적으로 관리하는 방향으로 발전하고 있다는 의미입니다.
마치며
세 기술을 나란히 놓고 보면 하나의 공통된 전제가 드러납니다. GPU HBM은 모든 데이터를 계속 담아둘 수 있는 무한한 자원이 아니라, 제한된 용량을 가진 가장 빠른 메모리 계층이라는 점입니다. 다만 KV Cache Offload, Sleep/Wake, NPU가 해결하려는 병목이 완전히 동일한 것은 아닙니다. 세 기술은 GPU 자원이 비효율적으로 사용되는 서로 다른 원인에 접근합니다.
KV Cache Offload는 반복해서 사용할 데이터를 GPU HBM에만 유지하지 않고 DRAM, NVMe, 외부 저장소 등으로 확장하여 캐시가 GPU 메모리를 지속적으로 점유하는 공간적 병목을 완화합니다. Sleep/Wake는 요청이 없는 모델까지 GPU 메모리를 계속 차지하지 않도록 하여 시간에 따른 유휴 자원 점유 문제를 해결합니다. NPU는 모든 추론 워크로드를 GPU에서 처리해야 한다는 전제에서 벗어나 적합한 연산을 다른 가속기로 분산함으로써 가속기 자원 자체의 배치와 활용에서 발생하는 병목을 완화합니다.
즉, 하나인 것은 세 기술의 개별 병목이 아니라 제한된 GPU 자원을 보다 효율적으로 활용해야 한다는 상위의 문제의식입니다. 공간, 시간, 하드웨어라는 서로 다른 축에서 접근하지만, 궁극적으로는 제한된 가속기 자원으로 더 많은 추론 워크로드를 처리하기 위한 방법이라는 점에서 서로 연결됩니다.
각 기술에는 그에 따른 트레이드오프도 존재합니다. 따라서 특정 기술의 우수성만으로 도입 여부를 판단하기보다는 실제 서비스에서 어떤 병목이 발생하고 있는지를 먼저 확인해야 합니다.
병목 현상은 워크로드에 따라 다르게 나타납니다. 긴 컨텍스트와 반복 프롬프트가 많은 서비스에서는 KV Cache가 GPU 메모리를 빠르게 점유하고 동일한 Prefix에 대한 Prefill이 반복될 수 있습니다. 여러 모델을 동시에 운영하면서 모델별 트래픽 편차가 큰 환경에서는 요청이 거의 없는 모델도 GPU 메모리를 계속 점유하는 문제가 발생합니다. 특정 모델에 대규모 요청이 집중되는 환경에서는 GPU의 전력 소비, 랙 집적도, 공급 가능한 가속기 규모와 같은 인프라 측면의 제약이 병목으로 작용할 수 있습니다.
해결 방법도 이러한 병목에 맞춰 선택해야 합니다. 컨텍스트가 길고 프롬프트 재사용률이 높다면 KV Cache Offload를 통해 캐시 재사용 범위를 넓히는 방안을 우선 검토할 수 있습니다. 여러 모델을 트래픽 편차가 큰 환경에서 운영한다면 Sleep/Wake를 통해 유휴 모델의 GPU 메모리를 회수하는 방식이 효과적일 수 있습니다. 반면 특정 모델을 대규모로 지속해서 서빙하는 환경이라면 해당 모델과 프레임워크의 지원 여부, 처리량, 지연시간, 전력 효율 등을 기준으로 NPU를 포함한 다른 가속기 활용을 검토할 수 있습니다.
물론 각각의 해결책에는 고려해야 할 비용이 있습니다. KV Cache Offload는 캐시 계층 간 데이터 이동과 Cache Miss 시 발생하는 지연을 관리해야 하고, Sleep/Wake는 모델을 다시 활성화하는 Wake 지연이 서비스의 SLO를 만족하는지 확인해야 합니다. NPU는 모델 및 추론 프레임워크 호환성, 소프트웨어 생태계, 운영 도구와 경험의 성숙도를 함께 검토해야 합니다. 결국 중요한 질문은 “어떤 기술이 가장 앞서 있는가”가 아니라 “현재 워크로드에서 가장 큰 자원 병목은 무엇인가”입니다.
경쟁의 초점 역시 단순한 GPU 증설에서 보유한 가속기 자원을 얼마나 효율적으로 사용하는가로 이동하고 있습니다. 앞서 살펴본 서빙 최적화와 요청 라우팅, 그리고 이번 장의 메모리 최적화는 서로 다른 계층을 다루지만 공통적으로 동일한 목표를 갖습니다. 주어진 가속기 자원에서 더 많은 요청과 토큰을 안정적으로 처리하는 것입니다.
따라서 GPU 증설을 검토하기 전에 먼저 확인해야 할 것은 단순히 GPU가 몇 장 부족한지가 아닙니다. 현재 GPU 메모리에서 무엇이 얼마만큼의 공간을 점유하고 있는지, 유휴 상태의 모델이 얼마나 많은 자원을 차지하고 있는지, 반복 계산을 줄일 수 있는 캐시가 충분히 활용되고 있는지, 그리고 모든 워크로드가 반드시 GPU에서 실행되어야 하는지를 먼저 살펴볼 필요가 있습니다. GPU 메모리 병목을 해결하는 출발점은 GPU를 더 확보하는 것이 아니라, 현재 가진 GPU와 메모리가 어떻게 사용되고 있는지를 정확히 이해하는 것입니다.
References
- Samsung SDS, 토큰 팩토리의 생산성을 끌어올리는 인퍼런스 기술
https://www.samsungsds.com/kr/insights/token-factory-llm-serving-inference.html - NVIDIA Dynamo, Set up KV Cache Offloading
https://docs.nvidia.com/dynamo/latest/kubernetes/kv-cache-offloading/overview - vLLM, v0.28.0 SimpleCPUOffloadConnector 소스
https://github.com/vllm-project/vllm/blob/v0.28.0/vllm/distributed/kv_transfer/kv_connector/v1/simple_cpu_offload_connector.py - LMCache, Benchmarking
https://docs.lmcache.ai/getting_started/benchmarking.html - Qin et al., Mooncake: Trading More Storage for Less Computation, FAST 2025
https://www.usenix.org/conference/fast25/presentation/qin - Compute Express Link Consortium, About CXL
https://computeexpresslink.org/about-cxl/ - Jang et al., HyMCache: A KV Cache Framework for Multi-Turn LLM Serving with CXL-Hybrid Memory, 2026
https://arxiv.org/abs/2607.18141 - Qwen, Qwen3.8-27B config.json
https://huggingface.co/Qwen/Qwen3.8-27B/blob/main/config.json - DeepSeek, DeepSeek-R1-0528 Release
https://api-docs.deepseek.com/zh-cn/news/news250528/ - DeepSeek, DeepSeek-V4 Models & Pricing
https://api-docs.deepseek.com/quick_start/pricing - Stanford Digital Economy Lab, How Do AI Agents Spend Your Money?
https://digitaleconomy.stanford.edu/publication/how-do-ai-agents-spend-your-money-analyzing-and-predicting-token-consumption-in-agentic-coding-tasks/ - WEKA, NeuralMesh Architecture
https://www.weka.io/wp-content/uploads/files/resources/2025/06/neuralmesh-architecture-weka.pdf - LMCache, Storage Backend 소스
https://github.com/LMCache/LMCache/tree/5703ad9dcc92ceb20cbf22ef2a5dc2340533690e/lmcache/v1/storage_backend
FAQ
-
GPU 사용률이 낮은데도 새 요청을 처리하지 못하는 이유는 무엇입니까?
GPU 사용률은 연산 유닛의 사용 정도를 보여주는 지표입니다. GPU 메모리에는 모델 가중치와 KV Cache, Activation, 연산 임시 공간 등이 함께 올라가기 때문에 연산 여유가 있어도 HBM이 가득 차면 새 요청을 처리하지 못할 수 있습니다. 특히 긴 컨텍스트와 동시 요청이 늘어나면 KV Cache가 빠르게 메모리를 점유합니다.
-
KV Cache Offload는 어떤 문제를 해결하며 언제 필요합니까?
KV Cache Offload는 GPU HBM에 저장된 KV Cache를 CPU 메모리, 로컬 디스크 또는 공유 저장소로 옮겨 보관하는 기술입니다. 동일한 Prefix나 긴 입력이 반복될 때 저장된 캐시를 다시 불러오면 Prefill을 처음부터 반복하지 않아도 됩니다. 긴 컨텍스트와 반복 프롬프트가 많은 서비스에 적합하지만, 캐시 전송 시간과 재계산 비용을 함께 비교해야 합니다.
삼성SDS 내부 실험에서는 약 65K Token의 동일 Prompt를 재사용했을 때 TTFT가 6.341초에서 0.495초로 줄어 약 12.8배 빨라졌습니다. 다만 실제 효과는 모델과 하드웨어, 시스템 부하에 따라 달라질 수 있습니다. -
Sleep/Wake는 KV Cache Offload와 어떻게 다릅니까?
KV Cache Offload가 이미 생성된 캐시를 GPU 외부로 옮겨 저장 공간을 확보하는 기술이라면, Sleep/Wake는 요청이 없는 모델의 가중치와 KV Cache를 HBM에서 비워 유휴 GPU 자원을 회수하는 기술입니다. 프로세스와 CUDA 컨텍스트 등을 유지한 채 모델을 Sleep 상태로 전환하고, 요청이 들어오면 Wake Up을 통해 다시 활성화합니다. 여러 모델의 트래픽 편차가 큰 환경에서 효과적이지만 Wake 지연과 피크 시간대의 자원 경합을 확인해야 합니다.
-
NPU를 도입하면 GPU보다 항상 비용 효율이 높아집니까?
그렇지는 않습니다. NPU는 추론에 특화된 가속기지만, 비용 효율성은 모델과 워크로드에 따라 달라집니다. 동일한 모델과 서비스 수준을 기준으로 처리량, 전력 소비량, 장비 가격, 시간당 비용, 백만 토큰당 비용, 모델·프레임워크 호환성을 함께 비교해야 합니다. 따라서 NPU는 GPU를 무조건 대체하는 기술이라기보다 특정 추론 워크로드에 맞춰 GPU를 보완하거나 대체할 수 있는 선택지입니다.
-
KV Cache Offload, Sleep/Wake, NPU를 함께 사용할 수 있습니까?
함께 사용할 수 있습니다. KV Cache Offload는 메모리 공간, Sleep/Wake는 시간에 따른 자원 점유, NPU는 하드웨어 선택의 문제를 해결합니다. 긴 컨텍스트와 반복 입력이 많으면 KV Cache Offload를, 여러 모델의 사용 시간이 크게 다르면 Sleep/Wake를, 특정 모델의 추론 처리량과 전력 효율이 중요하면 NPU를 우선 검토할 수 있습니다. 실제 서비스에서는 캐시 위치를 고려한 라우팅과 이종 가속기 자원 관리까지 함께 설계해야 합니다.
- 이 아티클은 AI를 활용하여 제작되었습니다.
- 본문에 사용한 이미지는 자체 기획하였으며, 이미지 제작 및 원고 검토 과정에서 생성형 AI(Claude, ChatGPT)를 활용했습니다.