Executive Summary
- 기업 AI의 성과는 모델 성능뿐 아니라, 기업 고유의 업무 맥락(컨텍스트)을 이해하는 능력에 달려 있습니다.
- 컨텍스트 계층은 데이터에 의미와 규칙을 더해, AI의 분석을 실제 업무 실행으로 연결합니다.
- 축적된 운영 지식을 AI가 활용할 수 있도록 체계화하면, 경쟁사가 모방하기 어려운 자산이 됩니다.
AI는 엉뚱한 곳에서 싸우고 있다
부품 공급에 차질이 생긴 한 글로벌 제조사가 대응 방법을 AI 비서에게 묻는다. AI는 유창하고 확신에 찬 답을 내놓는다. 대체 공급사로 전환하라는 것이다. 그럴듯하지만 틀린 답이다. 그 공급사는 이미 다른 제품 라인으로 생산능력이 차 있고, 전환은 핵심 고객과의 납품 약속을 깨며, 재무적으로는 오히려 손실이 크다. 모델이 약해서가 아니다. 모델은 탁월했다. 다만 그 기업이 어떻게 돌아가는지를 몰랐을 뿐이다.
문제는 AI 모델의 품질이 아니다. 가트너는 "데이터의 맥락 즉 컨텍스트 역량이 AI의 두뇌로 작동한다"고 규정하며, 에이전트는 고품질의 컨텍스트와 신뢰 없이는 자율적으로 기능할 수 없다고 못 박았다. 기업 AI 투자 중 측정 가능한 성과를 내는 것은 다섯에 하나뿐이고, 자사의 AI 투자가 긍정적 효과를 낼 것이라 확신하는 리더는 39%에 그친다.[1] 지금 대부분의 기업은 더 똑똑한 모델과 더 매끄러운 인터페이스를 좇으며 싸우고 있다. 그러나 진짜 집중해야 할 곳은 다른 곳에 있다.
기업을 실제로 강하게 만드는 것은 모델이 아니다. 심지어 원석 상태의 데이터도 아니다. 그 둘 사이에 놓인 컨텍스트를 읽는 컨텍스트 계층, 곧 우리 회사가 무엇을 의미하고 어떻게 작동하는지를 기계가 읽을 수 있게 표현한 층이다. 이것은 시맨틱(합의된 정의), 온톨로지(사물과 행동의 지도), 지식그래프(그 정의를 실제 데이터에 연결한 것), 그리고 그 위를 관통하는 권한과 거버넌스로 이루어진다. 비유하자면, 컨텍스트 없는 AI는 '문자열'을 보고, 컨텍스트 위의 AI는 '사물'을 본다. 전자가 그럴듯한 추측을 내놓는다면, 후자는 기업 비즈니스 현실에 접지된 판단을 내린다.
이 차이는 기업의 세 가지를 바꾼다. 투자의 무게중심이 어디로 가야 하는지, 무엇이 복제 불가능한 경쟁력이 되는지, 그리고 AI가 통찰에 그치지 않고 실행으로 넘어갈 수 있는지다. 가트너에 따르면 AI 준비도가 높은 조직은 최대 65% 더 나은 사업 성과를 내고, 그 기반에 평균 네 배 더 투자한다. 수십 년 치 운영 복잡성을 쌓아온 국내 대기업에 이 컨텍스트 계층은, 그 복잡성이 해자가 되느냐 부채로 남느냐를 가르는 분기점이다.
1. 좋은 모델을 쓰고도 틀리는 이유
2026년 기업 AI에는 이상한 사실이 하나 있다. 모델은 그 어느 때보다 뛰어난데, 성과는 제자리라는 것이다. 문제는 모델의 능력이 아니라, 모델이 회사를 이해하지 못한다는 데 있다.
모델은 좋아지는데 성과는 제자리
지난 2년간 모델의 성능은 비약적으로 올랐다. 그러나 MIT의 조사에 따르면 기업 생성형 AI 파일럿의 95%가 손익에 측정 가능한 영향을 주지 못했고, 그 원인은 모델의 품질이 아니라 기업 업무와의 통합 실패로 지목됐다.[2] 모델과 실제 업무 사이의 간극이 성과를 막는 것이다. 더 나쁜 경우도 있다. 컨텍스트에서 분리된 지능은 성과 없는 활동을 양산할 뿐 아니라, 때로는 분열과 위험을 만든다. 한쪽 워크플로우를 효율화한 에이전트가 다른 쪽의 계획 전제를 무너뜨리고, 그럴듯하게 들리는 추천이 시스템 어딘가의 결정적 의존관계를 놓친다. 기업에 부족한 것은 AI의 산출물이 아니라 그 산출이 운영상 어떤 결과를 부르는지 이해하는 AI다.
'문자열'을 보는 AI, '사물'을 보는 AI
왜 뛰어난 모델이 회사를 이해하지 못하는가. 범용 모델은 텍스트, 곧 문자열을 읽기 때문이다. 어떤 데이터베이스 테이블 이름이나 사용자 ID를 봐도, 그것이 무엇인지는 알지 못한다. "내일 런던에 갈 수 있나"라는 물음 앞에서, 모델은 'TBL_FLIGHT_402' 같은 테이블을 볼 뿐 그것이 '항공편'이며 특정 '조종사'에 연결돼 있고, 조종사가 아프면 '운항 취소'라는 행동이 가능해진다는 사실을 알지 못한다. 인터넷 전체를 읽었지만 우리 회사는 읽지 못한 것이다. 그래서 모델은 빈자리를 그럴듯한 추론으로 메운다. 그리고 확신에 찬 어조로 전달되는 그럴듯한 추론이야말로 가장 위험한 실패다.
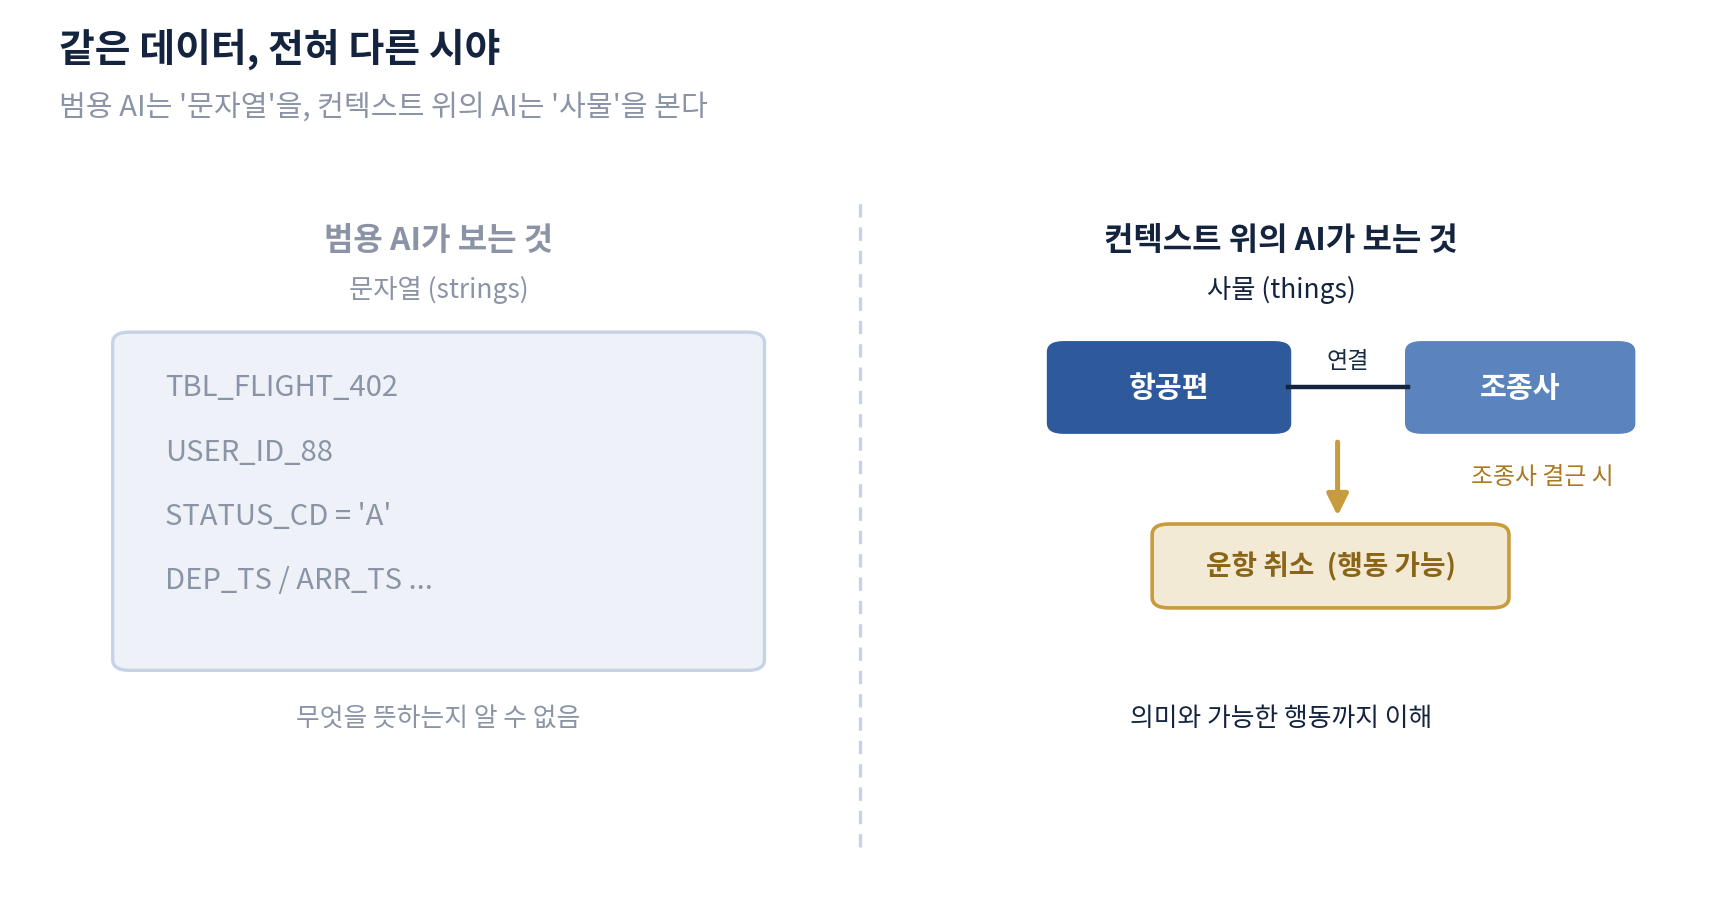 [그림 1] 문자를 읽는 AI vs. 사물을 보는 AI (출처: 저자 자체 제작)
같은 데이터, 전혀 다른 시야
범용 AI는 '문자열'을, 컨텍스트 위의 AI는 '사물'을 본다
- 범용 AI가 보는 것 - 문자열 (strings)
- TBL_FLIGHT_402
- USER_ID_88
- STATUS_CD ='A'
- DEP_TS / ARR_TS ...
- 무엇을 뜻하는지 알 수 없음
- 컨텍스트 위의 AI가 보는 것 - 사물 (things)
- 항공편 - 연결 - 조종사 - 조종사 결근 시 - 운항 취소 (행동 가능)
- 의미와 가능한 행동까지 이해
포레스터의 진단대로, 아무리 진보한 AI라도 컨텍스트가 담긴, 기계가 읽을 수 있는 지식으로 바뀌지 않는 한 자신 있게 틀린 답을 내놓는다.[3] 문제는 모델이 거짓말을 한다는 것이 아니라, 무엇을 의미하고 무엇을 해도 되는지 아무도 알려주지 않아 허공에서 추측한다는 데 있다.
그래서 경쟁은 엉뚱한 곳에서 벌어진다. 업계는 눈에 보이는 표면을 최적화한다. 더 큰 모델, 더 매끄러운 코파일럿, 더 많은 오케스트레이션. 데모가 인상적인 곳에 집중한다. 그러나 기업은 프롬프트로 돌아가지 않는다. 의존관계와 승인, 정책, 재무적 결과가 실시간으로 맞물리는 실행으로 돌아간다. 이 운영 현실에서 분리된 지능은 접지된 판단이 아니라 교육받은 추측을 내놓을 뿐이다. 경쟁의 질문은 조용히 옮겨갔다. '누구의 모델이 더 똑똑한가'에서 '누구의 AI가 우리 회사를 이해하는가'로. 그리고 이 질문의 답은 컨텍스트 계층에 있다.
2. 컨텍스트란 무엇인가: 시맨틱·온톨로지·지식그래프
우리는 자주 "컨텍스트가 빠졌다"는 말을 한다. 그러나 '컨텍스트'는 그 자체로는 모호한 말이다. 실제로 그것은 세 개의 뚜렷한 층으로 이루어지며, 이 셋이 함께 데이터를 AI가 추론하고 행동할 수 있는 지식으로 바꾼다.
세 개의 층
용어가 자주 뒤섞이지만, 역할은 분명히 다르다. 온톨로지(ontology)는 무엇이 존재하고 어떻게 연결되는지를 정의하는 '개념 지도'다. 시맨틱(semantics)은 그 정의에 일관성을 강제한다. 지식그래프(knowledge graph)는 그 정의를 실제 데이터에 연결해 추론 가능한 네트워크로 만든다.
온톨로지가 지식을 정의하고, 시맨틱이 명료성과 일관성을 지키며, 지식그래프가 이들을 연결해 추론과 발견을 떠받친다. 가장 흔한 실패가 이 셋의 부재를 드러낸다. "상위 5개 고객"을 물을 때마다 다른 답이 나오는 이유는, 팀마다 '고객'과 '상위'를 다르게 해석하기 때문이다. 시맨틱 레이어는 그 정의를 한 곳에 고정해, 질문이 매번 추론이 아니라 검증된 정의로 답하게 한다.
이 가운데 온톨로지가 핵심이다. 온톨로지는 비즈니스의 '명사와 동사'다. 명사는 객체다. 공장, 고객, 주문, 화물 같은 실제 사물. 동사는 행동이다. 주문 생성, 재고 이동, 승인 같은 실제 실행. 온톨로지는 흩어진 데이터 테이블을 이 명사와 동사로 번역해, 조직의 운영 모델, 곧 회사의 디지털 트윈을 만든다.
범용 모델은 'TBL_FLIGHT_402'라는 문자열을 보지만, 온톨로지 위의 AI는 '항공편 객체'와 거기 연결된 '조종사', 그리고 조종사가 아플 때 가능한 '운항 취소'라는 행동을 본다.
데이터에서 실행까지의 사슬
그래서 컨텍스트 계층은 데이터를 한 단계씩 끌어올린다. 원시 데이터에서 비즈니스 객체로, 다시 AI가 이해하는 지식으로, 마지막으로 실행 가능한 행동으로. 서문의 공급 차질 사례가 바로 이 사슬이 끊겨 있던 경우다. 결정적인 것은, 이 사슬에 권한과 규칙이 함께 박힌다는 점이다. 온톨로지는 객체와 관계만이 아니라 '누가 무엇을 해도 되는가'까지 담는다. 그래서 AI는 추론에 그치지 않고, 통제된 경계 안에서 실제 시스템에 되쓰기하며 행동할 수 있다. 데이터는 의미를 입어야 자산이 되고, 스스로 도는 에이전트는 온톨로지가 있어야 무엇을 건드려도 되는지 안다. 컨텍스트 계층은 '통찰'과 '실행' 사이에 놓인 다리다.
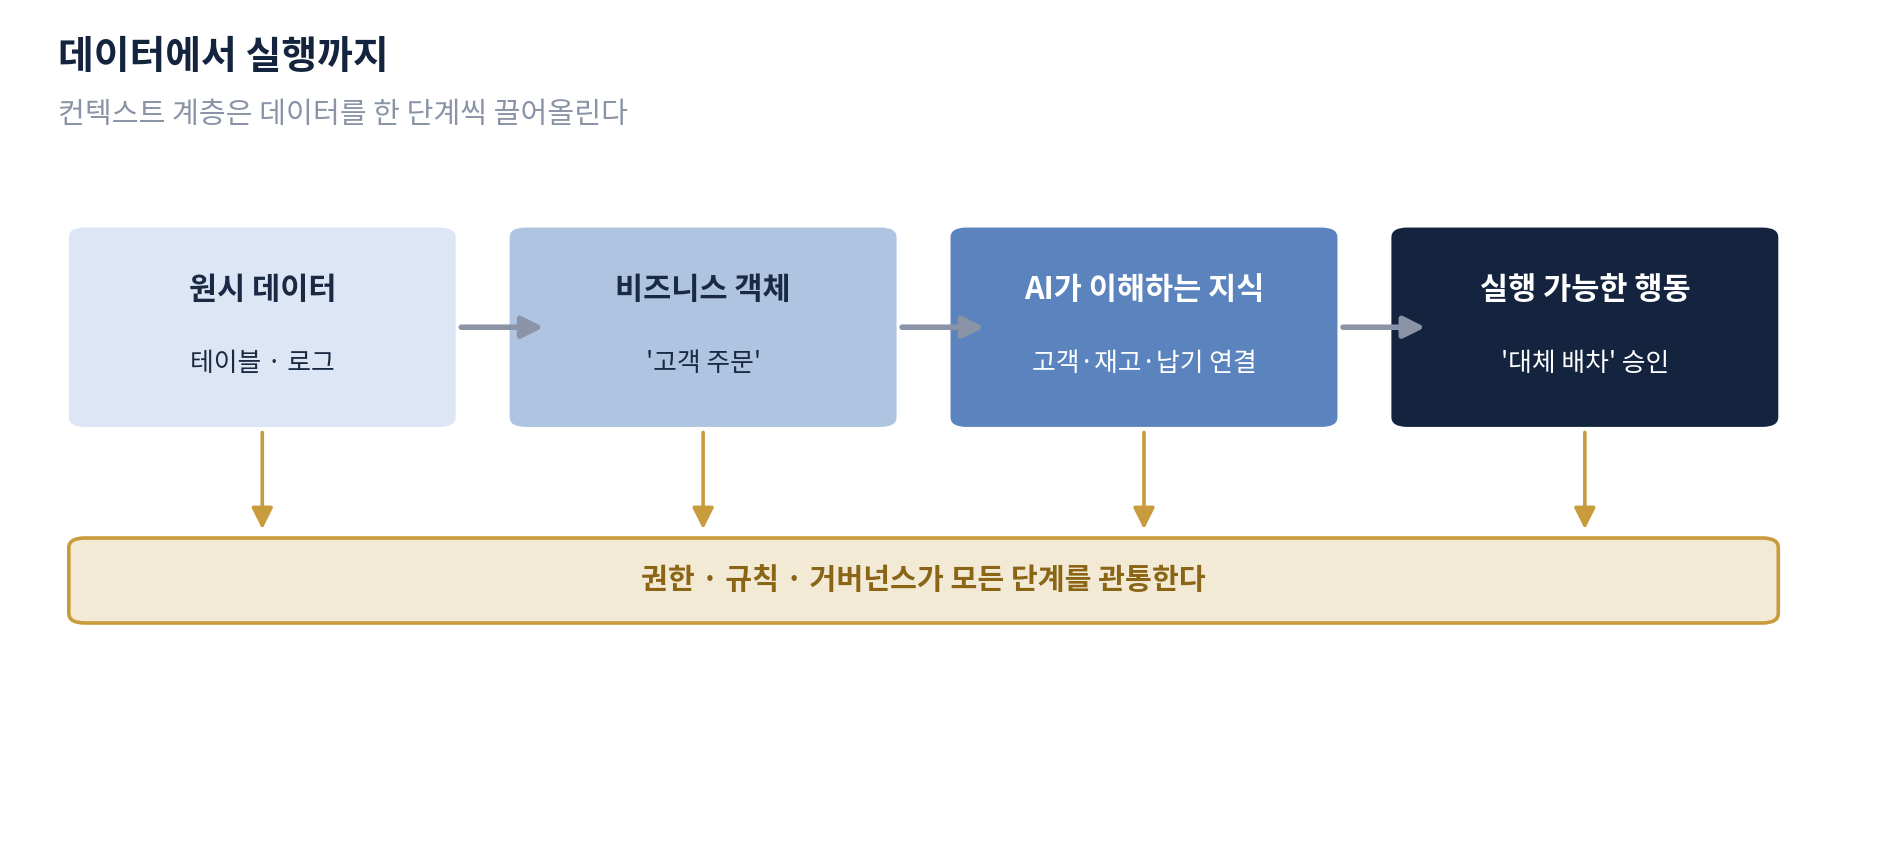 [그림 2] 컨텍스트 계층의 데이터 사슬 (출처: 저자 자체 제작)
데이터에서 실행까지
컨텍스트 계층은 데이터를 한 단계씩 끌어올린다
원시 데이터(테이블 · 로그) → 비즈니스 객체('고객 주문') → AI가 이해하는 지식(고객 ·재고·납기 연결) → 실행 가능한 행동('대체 배차' 승인) / 권한 · 규칙 · 거버넌스가 모든 단계를 관통한다
효과는 수치로 나타난다, 그리고 그 한계도. 접지의 효과는 측정된다. 데이터브릭스가 2026년 6월 공개한 자체 벤치마크에서, 동일한 질문과 동일한 모델에 온톨로지라는 컨텍스트를 입히자, 데이터 질의 정확도가 약 50%에서 84.5%로 뛰었다. 컨텍스트 없는 범용 에이전트는 52.4%, 가장 단순한 방식은 25%에 그쳤다. 정확도를 가른 것은 알고리즘이 아니라 데이터에 입혀진 의미였다.[4] 그러나 물론 과신은 금물이다. 84.5%라도 여섯에 하나는 여전히 틀리고, 온톨로지는 답의 정확성을 보장하지 않는다. 불확실성을 표시하지도, 틀린 답을 거부하지도 않는다. 컨텍스트 계층은 추측을 판단으로 바꾸지만, 그 판단을 검증하는 일은 또 다른 층의 몫이다. 바로 이 지점이, 컨텍스트 계층이 한 번 설치하면 끝나는 제품이 아니라 지속적으로 가꾸어야 하는 자산인 이유다.
3. 왜 이것이 해자인가
같은 모델, 갈라지는 결과
같은 모델을 쓰는 두 기업이라도 컨텍스트 인프라가 다르면 결과는 근본적으로 갈린다. 더 나은 컨텍스트를 가진 쪽이 어떤 모델을 쓰든, 거의 모든 유스케이스에서 일관되게 앞선다. 모델은 상품화되어 누구나 같은 것을 호출하지만, 컨텍스트는 기업마다 다르다. 그러므로 차별화는 모델이 아니라 컨텍스트에서 나온다.
컨텍스트 계층은 한 번 만들고 끝나는 자산이 아니다. 쓸수록 똑똑해진다. 전문가가 교정한 정의, 새로 추가된 규칙, 축적된 의사결정 기록이 계속 쌓이면서 시간이 갈수록 격차가 벌어진다. 2년을 투자한 기업은 6개월 전 시작한 경쟁자보다 단순히 앞선 것이 아니라 구조적으로 큰 차별점을 만든다. 더 결정적인 것은, 이 층을 돈으로 살 수 없다는 점이다. 컨텍스트 계층은 우리 회사를 그대로 인코딩한 것이기 때문이다. 우리의 사물, 우리의 규칙, 우리의 승인 체계, 우리의 도메인 지식. 범용 제품으로 구매하는 모델과 달리, 이것은 본질적으로 맞춤이며 조직 안에서만 자라난다. 경쟁자가 자본으로 복제할 수 없는 유일한 층인 셈이다. 가트너가 시맨틱 레이어를 '타협 불가능한 기반'으로 규정하고, 2030년이면 데이터 플랫폼·사이버보안과 나란한 핵심 인프라가 되리라 본 이유이다.
선점 기회, 그리고 느린 기업의 함정
그래서 투자의 무게중심이 더 많은 모델 구독과 더 큰 모델에서, 그 모델을 쓸모 있게 만드는 시맨틱 인프라로 이동 중이다. 가트너의 조사는 AI에 성공한 조직은 데이터·분석 기반에 평균 네 배 더 투자하고, AI 준비도가 가장 높은 조직은 최대 65% 더 나은 사업 성과를 낸다고 한다. 그리고 이 우위에는 중요한 시한이 있다. 2026년에 컨텍스트 아키텍처를 정의해 둔 기업은, 에이전트 워크로드가 폭증하는 2027-28년에 그것을 다시 짓지 않아도 된다. 지금 세운 기업에 그 우위는 구조가 된다.
반대로 느린 기업은 이 컨텍스트를 애플리케이션의 문제로 다룬다. AI 앱마다 제각기 검색 파이프라인과 데이터 연결, 메타데이터를 따로 만든다. 그 결과 조직 전체에는 서로 말이 통하지 않는 컨텍스트 파편만 흩어진다. 컨텍스트가 공용 인프라가 아니라 앱의 부가 기능으로 머무는 한, 해자는 만들어지지 않는다. 그렇다면 이 해자는 어디에서 가장 깊게 만들어질까? 상식적으로 복잡성이 가장 두텁게 쌓인 곳, 곧 수십 년 치 운영 지식을 축적해 온 기업에서다. 국내 대기업이 바로 강점으로 서 있는 부분이다.
4. 복잡성이 큰 자산이다
국내 대기업의 업무 복잡성은 해자의 원천이다. 다만 지금은 자산이 아니라 짐으로 쌓여 있다.
복잡성이 곧 원석
국내 대기업은 제조와 물류, 금융, 통신에서 수십 년 치 운영 지식을 축적해 왔다. 공정의 미묘한 예외를 어떻게 처리하는지, 수천 개의 화물을 어떤 논리로 배차하는지, 여신을 어떤 예외 규칙으로 심사하는지, 통신망 장애에 어떤 경험으로 대응하는지. 이것은 공개 웹 어디에도 없고 경쟁자가 돈으로 살 수도 없는, 가장 값진 지식이다. 지난 리포트[5]에서 방치된 운영 데이터가 복제 불가능한 자산으로 재평가된다고 했기에, 그 자산이 가장 두텁게 쌓인 곳이 바로 이들 기업이라고 할 수 있다. 그러나 이 복잡성은 역설적으로 짐이기도 하다. 지식이 ERP와 레거시 시스템의 테이블에, 그리고 더 많게는 베테랑 직원들의 머릿속과 로컬 파일에 흩어져 있어 AI가 읽을 수 없기 때문이다. 복잡성이 깊을수록, 접지되지 않은 AI는 더 크게 틀린다. 국내 대기업은 가장 큰 잠재 자산과 가장 큰 미접지 위험을 동시에 쥐고 있는 셈이다.
짐을 자산으로 바꾸는 것은 '컨텍스트'다. 데이터는 의미를 입기 전까지 자산이 아니라 쓰이지 못한 채 쌓이는 재고다. 수십 년의 운영 지식을 온톨로지와 시맨틱으로 끌어내 기계가 읽을 수 있는 형태로 옮길 때, 비로소 복잡성은 해자로 전환된다. 그리고 복잡성이 깊을수록 전환 보상도 크다. 범용 플랫폼이 흉내 낼 수 없는 깊이이기 때문이다.
이 구조가 국내 대기업에 유리한 이유는 분명하다. 컨텍스트 계층은 자본이 아니라 도메인 지식과 시간으로 쌓이고, 수십 년의 축적은 단기에 복제되지 않는다. 글로벌 빅테크가 더 뛰어난 모델을 내놓더라도, 우리 공정과 우리 거래와 우리 망을 이해하는 것은 우리가 직접 지은 컨텍스트 계층뿐이다. 모델은 모두의 것이지만, 컨텍스트는 우리만의 것이다.
기술이 아닌 조직의 과제
함정도 분명하다. 컨텍스트 계층은 구매해서 설치하는 제품이 아니라 조직이 가꾸는 자산이며, 그래서 가장 큰 장벽은 기술이 아니라 거버넌스와 소유권이다. 베테랑의 암묵지를 통치 가능하고 질의 가능한 형태로 옮기려면, 누가 '활성 고객'의 정의를 확정하는지, 누가 객체와 행동과 권한을 소유하는지, 변경을 누가 관리하는지를 먼저 정해야 한다. 데이터를 지키던 관리자의 역할이 '컨텍스트를 관리하는' 역할로 진화해야 한다는 뜻이다. 더 나아가 이 의미 계층에는 권한과 규칙이 함께 박히므로 “누가 무엇을 해도 되는가, 그 행동이 기록으로 남는가”와 같은 거버넌스 질문이 컨텍스트 계층 안에서 함께 구현된다.
접지와 권한이 설계된 컨텍스트 계층은, 국내 개인정보보호 환경이 요구하는 설명 책임, 곧 AI가 무엇에 근거해 무엇을 했는지를 증명하는 능력과도 맞물린다. 결국 국내 대기업의 과제는 더 좋은 모델을 고르는 일이 아니다. 수십 년의 복잡성을 기계가 읽을 수 있는 의미로 번역할 사람과 체계를 세우는 일이다.
5. 마무리: 컨텍스트를 인프라로
지금까지의 분석은 하나의 결정으로 모인다. 기업 AI를 강하게 만드는 것은 더 좋은 모델이 아니라 그 모델을 회사의 현실에 접지시키는 컨텍스트 계층이라면, 리더는 이 층을 무엇으로 다룰 것인지를 정해야 한다. 답은 분명하다. 앱의 부가 기능이 아니라, 공용 인프라로 다루는 것이다.
컨텍스트를 공용 인프라로
컨텍스트 계층은 사이버보안이 그러하듯 전사가 공유하는 단일 기반으로 다뤄야 한다. 기술 부서의 과제가 아니라 전용 예산과 조직적 책임이 따르는 경영 의제라는 뜻이다. 가트너가 컨텍스트를 사이버보안과 같은 반열의 핵심 인프라로 규정한 것도 이 때문이다.
에이전트보다 컨텍스트를 먼저 정의
많은 기업이 순서를 거꾸로 밟는다. 에이전트를 먼저 붙이고 컨텍스트는 나중에 채우려 한다. 그러나 접지되지 않은 에이전트는 빠르게, 그리고 확신에 차서 틀린다. 그래서 에이전트를 배치하기 전에 먼저 정의해야 할 것들이 있다. AI가 추론해도 되는 객체는 무엇이고, 읽어도 되는 데이터는 어디까지이며, 실행해도 되는 행동은 무엇이고, 그 행동은 어떤 권한 아래 허용되며, 어떤 증거를 남겨야 하는가. 이 다섯 가지가 정의되지 않은 채 돌아가는 에이전트는 통제가 아니라 위험을 자동화한다. 컨텍스트 계층을 먼저 세운다는 것은, 바로 이 질문에 조직 차원의 답을 먼저 세운다는 뜻이다.
컨텍스트를 공용 인프라로 세우고 그 정의를 갖춰가는 단계에서, 마지막으로 마주하는 벽은 기술이 아니라 소유권이다. 컨텍스트 계층이 'AI의 두뇌'라면, 그 두뇌를 누가 가꾸고 책임지는지가 정해져야 한다. 정의를 확정하고, 규칙의 변경을 관리하며, 의미의 품질을 지키는 역할이다. 데이터를 지키던 관리자가 의미를 관리하는 역할로 진화하고, 도메인 전문가의 암묵지가 체계적으로 이 층에 이전되어야 한다. 모델은 구매 결정이지만, 컨텍스트는 조직 설계의 문제다. 성공하는 AI 도입이 결국 기술 전환이 아니라 변화 관리의 과제인 이유가 여기에 있다.
이번 글의 출발점은 "기업의 AI가 엉뚱한 곳에서 집중하고 있다"는 진단이었다. 진짜 해자는 더 똑똑한 모델이 아니라, AI가 우리 기업의 비즈니스를 이해하게 만드는 층에 있다. 모델은 누구나 살 수 있고 빠르게 상품화된다. 그러나 우리 비즈니스가 무엇을 의미하고 어떻게 작동하는지는 세상에 하나뿐이며, 돈으로 복제되지 않는다. 그것을 기계가 읽을 수 있는 의미로 바꿔낸 기업만이, AI를 통찰에서 실행으로 넘긴다. 기업 AI의 승부는 모델에서 갈리지 않는다. 컨텍스트에서 갈린다.
References
- Gartner, “Gartner Says Organizations with Successful AI Initiatives Invest Up to Four Times More in Data and Analytics Foundations”, 2026.04.16
- MIT NANDA, “State of AI in Business 2025”, 2025.07
- Forrester, “Why Semantics, Ontologies, And Knowledge Graphs Matter For Agentic AI”, 2026.06.02
- Databricks, “Databricks Data + AI Summit 2026”, 2026.06.16
- 김영욱, “AI 시대, 기업 데이터의 재발견: 버려지던 데이터가 원유가 되다”, 삼성SDS 인사이트리포트, 2026.09.23
FAQ
-
성능 좋은 AI 모델을 사용함에도 불구하고 기업 업무에서 틀린 답을 내놓는 이유는 무엇인가요?
모델의 지능이 부족해서가 아니라 기업이 어떻게 돌아가는지에 대한 '맥락(컨텍스트)'을 모르기 때문입니다. 범용 모델은 텍스트, 즉 문자열을 읽을 뿐 데이터가 실제 비즈니스에서 무엇을 의미하고 어떤 의존관계와 규칙이 있는지를 이해하지 못하며, 이 빈자리를 그럴듯한 추론으로 메우기 때문에 확신에 찬 오답을 내놓게 됩니다.
-
기업 AI의 성패를 가르는 '컨텍스트 계층'이란 정확히 무엇인가요?
우리 회사가 무엇을 의미하고 어떻게 작동하는지를 기계가 읽을 수 있게 표현한 층입니다. 이는 합의된 정의를 내리는 시맨틱(Semantics), 사물과 행동의 지도를 그리는 온톨로지(Ontology), 그리고 이 정의를 실제 데이터에 연결해 추론 가능한 네트워크로 만든 지식그래프(Knowledge Graph)로 구성됩니다.
-
AI가 '문자열'을 보는 것과 '사물'을 보는 것의 차이는 무엇인가요?
'문자열'을 보는 AI는 데이터베이스의 테이블 이름 같은 텍스트 자체만 인식하여 그럴듯한 추측을 내놓지만, '사물'을 보는 AI는 온톨로지를 통해 해당 데이터가 어떤 비즈니스 객체이며 어떤 행동과 연결되는지 이해합니다. 결과적으로 전자는 추측을 내놓고, 후자는 기업의 비즈니스 현실에 접지된 판단을 내립니다.
-
컨텍스트 계층이 어떻게 AI의 '통찰'을 '실행'으로 바꿀 수 있나요?
컨텍스트 계층은 원시 데이터를 비즈니스 객체와 지식으로 끌어올리고, 여기에 '누가 무엇을 해도 되는가'라는 권한과 규칙을 결합합니다. 이를 통해 AI는 단순한 분석이나 추천에 그치지 않고, 통제된 경계 안에서 실제 시스템에 데이터를 되쓰며 행동할 수 있는 능력을 갖추게 됩니다.
-
국내 대기업의 업무 복잡성이 어떻게 AI 시대의 '전략적 해자'가 될 수 있나요?
수십 년간 축적된 공정 예외 처리, 배차 논리, 심사 규칙 같은 운영 지식은 공개된 웹에 없으며 경쟁자가 돈으로 살 수 없는 독보적인 자산입니다. 이 복잡한 암묵지를 온톨로지와 시맨틱으로 체계화하여 기계가 읽을 수 있는 컨텍스트 계층으로 구축하면, 글로벌 빅테크의 모델조차 흉내 낼 수 없는 강력한 경쟁 우위가 됩니다.
-
기업이 AI 에이전트를 도입할 때 가장 주의해야 할 순서는 무엇인가요?
에이전트를 먼저 배치하고 나중에 컨텍스트를 채우는 것이 아니라, 컨텍스트 계층을 먼저 정의해야 합니다. AI가 추론해도 되는 객체, 읽어도 되는 데이터 범위, 실행 가능한 행동과 권한 등을 먼저 세우지 않고 에이전트를 도입하는 것은 통제가 아니라 '위험을 자동화'하는 일이 될 수 있기 때문입니다.
-
컨텍스트 계층을 개별 앱의 기능이 아닌 '공용 인프라'로 다뤄야 하는 이유는 무엇인가요?
앱마다 개별적으로 검색 파이프라인과 메타데이터를 만들면 조직 전체에 서로 말이 통하지 않는 컨텍스트 파편만 남게 되어 해자를 만들 수 없습니다. 사이버보안처럼 전사가 공유하는 단일 기반 인프라로 구축해야만 일관된 비즈니스 정의를 유지하고, 향후 에이전트 워크로드가 폭증하는 환경에서도 구조적인 우위를 점할 수 있습니다.